MEEP EXAMPLES 09
빛이 꺾이는 길을 스스로 찾게 하려면?
121개 밀도를 바꾸며 출력 도파관으로 빛을 보냅니다. 계산한 gradient를 검증하고, 최적화 점수와 실제 투과율을 구별해 봅니다.
이 글을 읽고 나면
- 정방향·수반 계산에서 밀도 gradient로 이어지는 과정을 설명한다.
- 유한차분으로 gradient를 확인하고 한 번의 설계 갱신을 해석한다.
- 별도 검증과 해상도 확인으로 설계의 한계를 판단한다.
먼저 알면 좋은 것 04편 EigenModeSource · 05편 bend와 정규화 · 08편 adjoint와 gradient gate
1. 먼저 보기: 회색 블록에서 빛은 어디로 갈까?
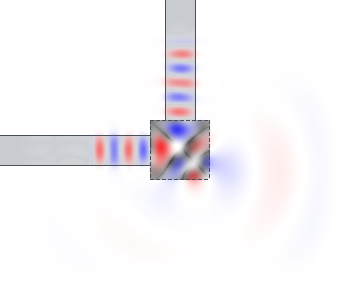
입력은 왼쪽, 원하는 출력은 위쪽입니다. 가운데 1 × 1 µm 정사각형의 재료만 바꿀 수 있다면, 빛이 90° 꺾이도록 어떤 구조를 만들면 될까요? 05편에서는 반지름 하나를 바꿨고, 이번에는 11 × 11 = 121개 밀도를 바꿉니다.
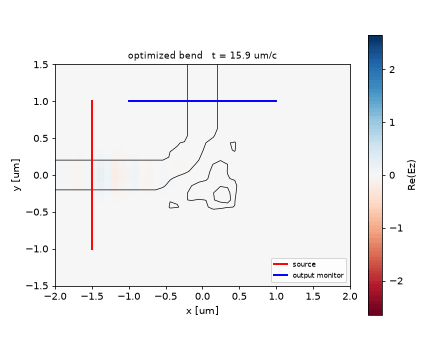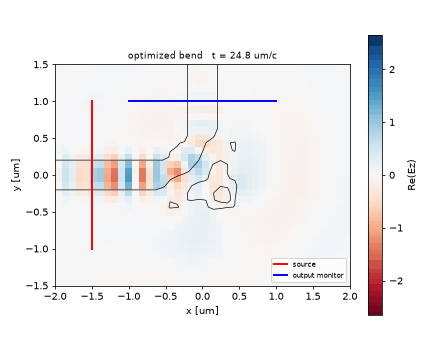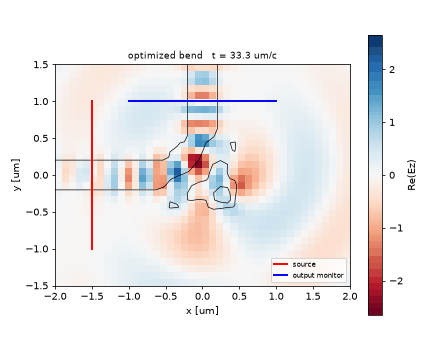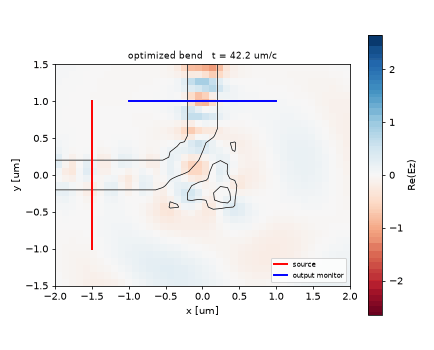
이 결과를 읽는 조건. 두 그림은 같은 해상도 10의 실제 Re(Ez) 결과입니다. 같은 설계를 해상도 20으로 다시 재면 투과율은 0.6391입니다. 121개 중 119개가 회색조이고 최적화는 5회 평가뿐이므로, 수렴한 설계나 제작 도면으로 볼 수 없습니다.
어디에 쓰이는가
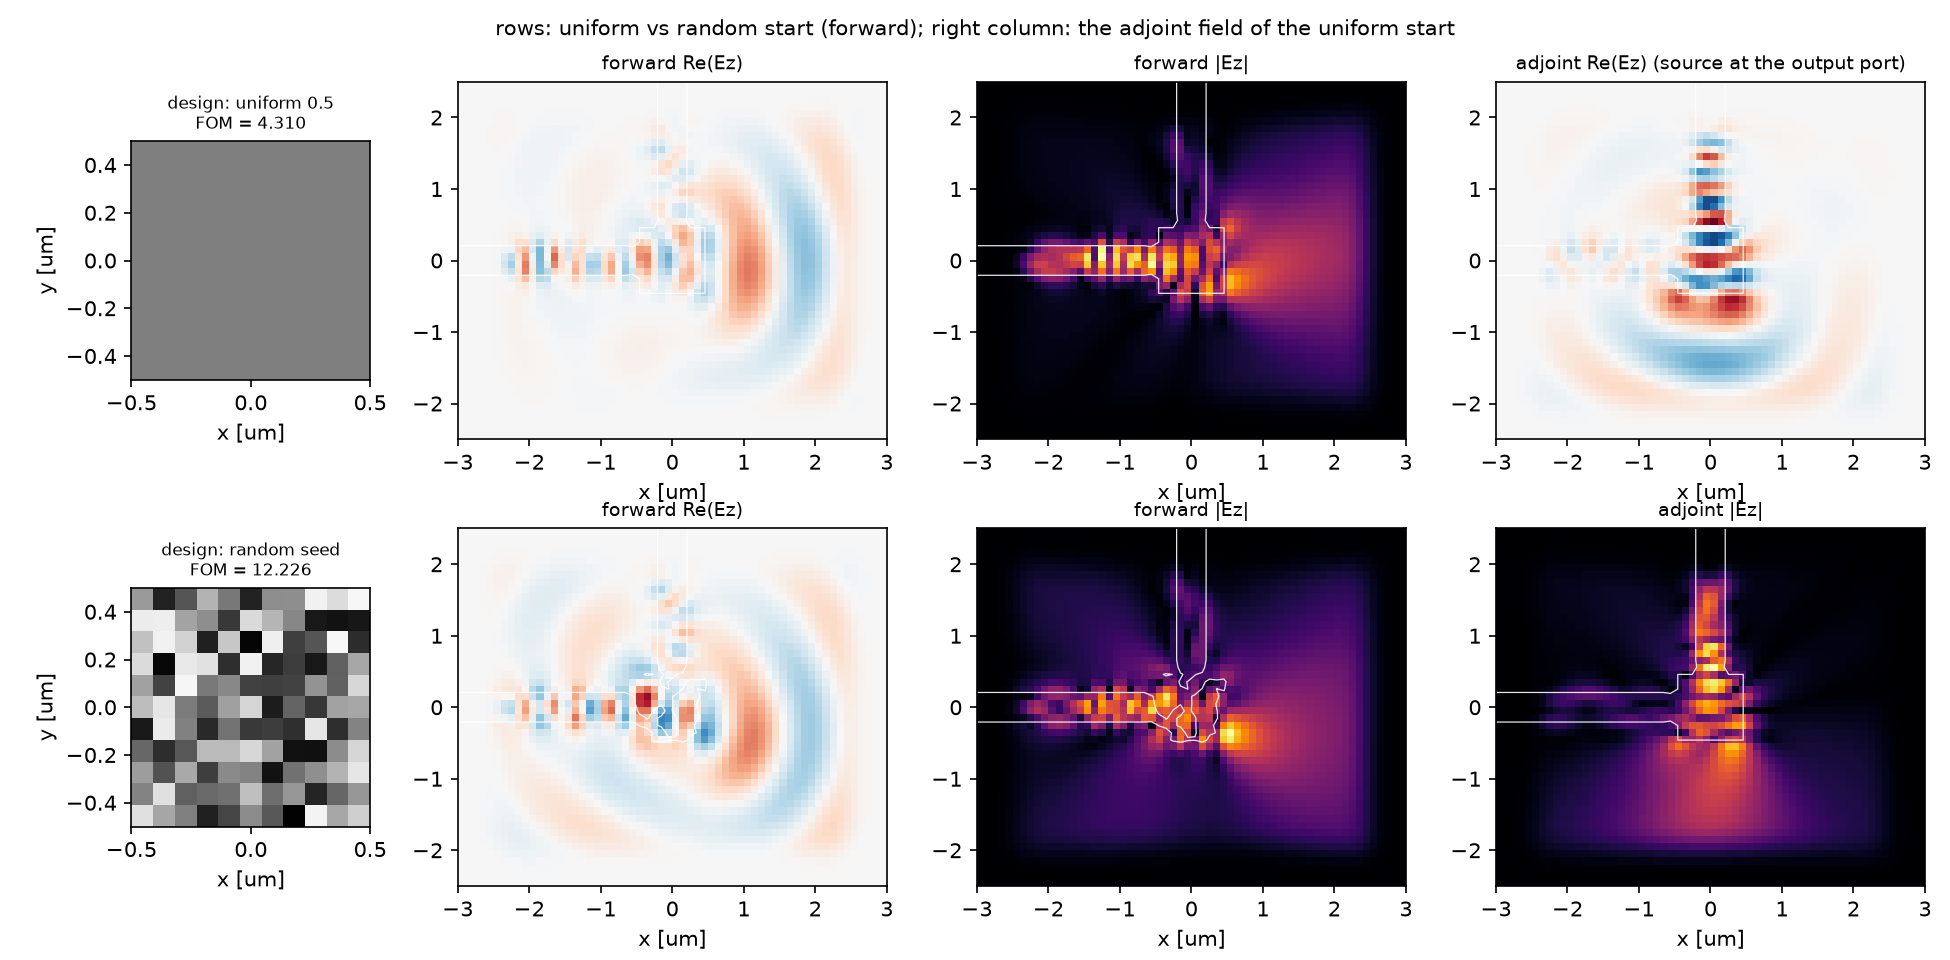
홈의 고해상도 DFT 예시는 빨강·파랑 파면 + 회색 구조로 표시합니다. 빨강은 음수, 파랑은 양수 Re(Ez)이며 약한 장은 투명하게 합성합니다. 회색은 고정 도파관과 연속 설계 밀도의 표시로, 저장된 실제 유전율 지도는 아닙니다. 원래의 복소장·위상·공통 색상 범위는 보존하고, gradient는 기존 RdBu로 구별합니다. 아래 저해상도 MMA 예제의 원본 그림과는 계산 이력이 다릅니다.
역설계 bend는 PIC 부품의 면적을 수십 배 줄이는 방법의 첫 예다. 같은 틀이 splitter, crossing, mode converter에 그대로 쓰인다.
| 응용 | 이 글의 어떤 것을 쓰는가 | 그 다음에 필요한 것 |
|---|---|---|
| 초소형 PIC 부품(bend, splitter, crossing, mode converter) | 자유 설계 영역 + 출력 모드 목적함수 | 31·33·34편 |
| foundry 제약 반영(최소 선폭, 이진화) | 회색조·선폭 문제의 발견 | 32편 filter·projection |
| 설계 변수 1개와 121개의 비교 | 05편 반지름 sweep과 이 글 | — |
2. 먼저 예측하기: gradient는 완성된 길을 그릴까?
지금 아는 것은 왼쪽에서 들어온 빛을 위로 보내고 싶다는 것뿐입니다. 균일한 출발점에서 계산한 첫 gradient가 무엇을 보여 줄지 골라 보세요.
예측과 실제 결과 비교하기
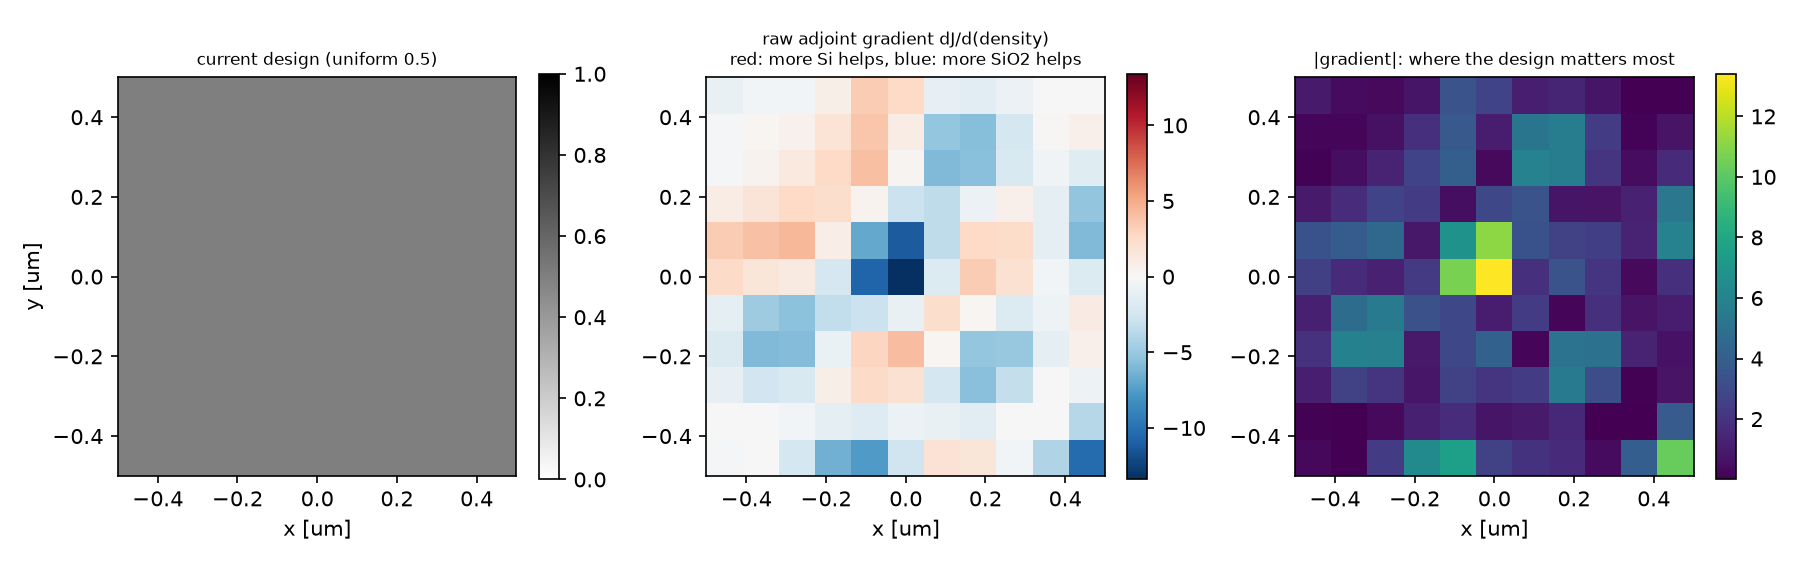
이 출발점에서는 두 번째에 가깝습니다. 가장 큰 절댓값은 중앙의 음수 −13.4이고, 양수는 두 도파관을 설계 영역 안으로 연장하는 부근에 있습니다. 대각선 모양은 큰 step 뒤 일부 밀도가 0이나 1에 닿으면서 나타납니다. 첫 미분은 현재 설계를 조금 바꿀 방향을 알려 주며, 완성된 형상을 직접 그려 주지는 않습니다.
3. 원리 이해하기: 두 계산에서 한 번의 갱신으로
밀도 ρ는 설계 영역 안의 재료를 정하는 숫자입니다. 0은 SiO₂, 1은 Si, 사이는 두 재료 사이의 보간 값입니다. 왼쪽과 위쪽의 폭 0.5 µm Si 도파관은 고정하고, 정사각형 안의 121개 값만 바꿉니다. 처음에는 모두 0.5이며, 바깥 배경은 공기입니다.
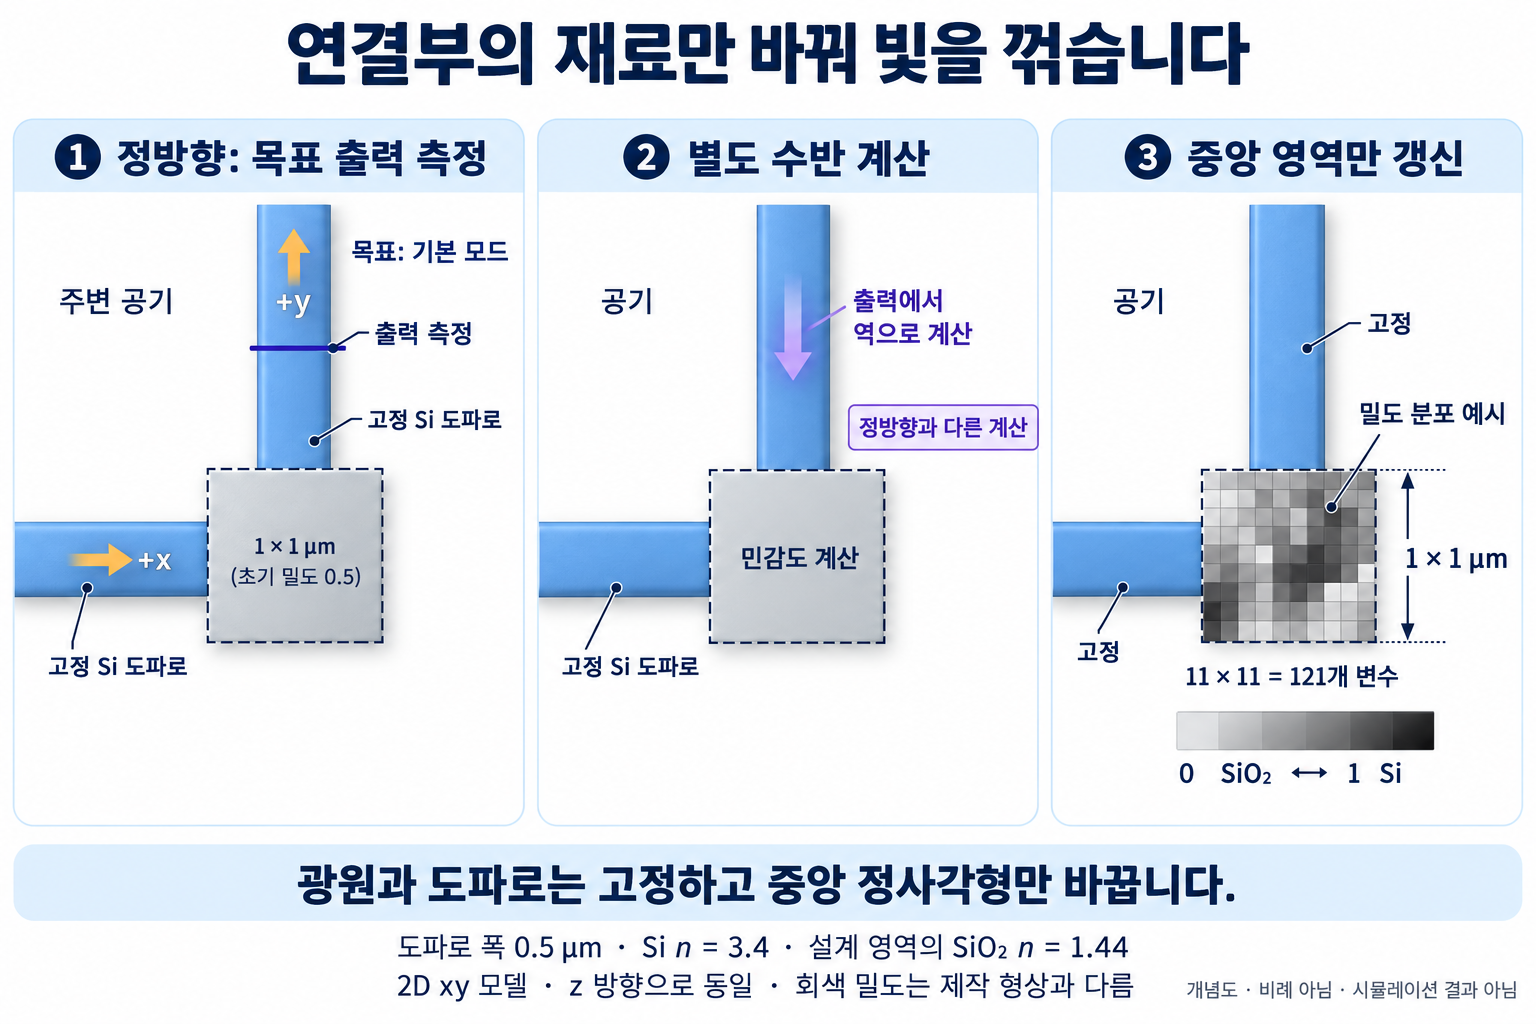
그림의 입력에서 빛을 보내는 계산이 forward, 출력의 목적함수에서 유도한 source로 설계 영역을 향해 응답을 구하는 별도 계산이 adjoint입니다. 저장한 두 field로 gradient를 구하고, 그 결과를 optimizer에 넘겨 밀도를 갱신합니다.
- Forward field: 왼쪽 입력 모드로 빛을 넣고, 위쪽 출력 포트의 mode 1 진폭을 구합니다.
- Adjoint field: 목적함수에서 유도한 source로 별도 계산합니다. 이 예제에서는 출력 포트에서 설계 영역 쪽으로 향합니다.
- Gradient: 저장한 두 field의 겹침과 재료의 밀도 의존성을 이용해 각 픽셀의 ∂J/∂ρ를 계산합니다.
- Geometry update: gradient를 검증한 뒤, optimizer가 0 ≤ ρ ≤ 1 안에서 밀도를 갱신합니다.
색을 읽는 기준. 이 그림의 색은 재료 밀도가 아니라 J의 민감도입니다. 밀도를 낮추는 것은 설계 영역 안에서 SiO₂ 쪽으로 옮긴다는 뜻입니다. 검정·회색·흰색으로 그린 밀도 지도와 구별하세요.
| 목적함수는 출력 mode 1 진폭의 제곱 **J = | a_out | ²입니다. 최적화 도중의 J는 optimizer의 정규화 관례를 따릅니다. 보고할 투과율은 최종 설계를 **새 시뮬레이션으로 측정하고, 직선 도파관 참조 run의 입력 mode 1 power로 나눈 값입니다. |
계산 범위: 2D Ez(TE), 파장 1.55 µm, Si 굴절률 3.4, SiO₂ 굴절률 1.44, 단일 주파수입니다. 설계 격자 11 × 11과 전자기장을 계산하는 Yee 격자는 서로 다릅니다. 최소 선폭과 이진화 제약은 없습니다.
수식·기호 자세히 보기
| 목적함수는 출력 포트 monitor에서 잰 mode 1 진폭의 제곱 J = | a_out | ²이다. 08편과 수학은 같다. forward field E_f는 입력 도파관의 EigenModeSource가 만들고, adjoint field E_a는 출력 포트 monitor 자리에서 거꾸로 쏜 EigenModeSource가 만든다. gradient는 두 field의 겹침에 재료의 밀도 의존성과 정규화 계수를 반영해 구한다. 아래 비례식은 그 관계를 개념적으로 나타낸 것이다. 08편에서 adjoint가 위쪽 평면파 monitor에서 내려왔다면, 여기서는 출력 도파관을 타고 설계 영역으로 내려온다. 목적함수가 바뀌면 adjoint source의 위치와 모양이 바뀐다. |
보고하는 투과율 T_mode1의 분모 P_in은 직선 도파관만 있는 참조 run에서 입력면(x = −1 µm)의 mode 1 power다. 분자는 최종 설계를 새 Simulation에 넣고 get_eigenmode_coefficients로 다시 잰 값이다. optimizer가 돌려주는 J는 이 분모와 같은 잣대로 정규화되어 있지 않다. 실제로 J/P_in은 1.056이 나온다.
| 기호 | 뜻 | 코드 변수 |
|---|---|---|
| ρ (121개) | 설계 밀도. 0 SiO2, 1 Si, 사이는 회색조 | x_start, x_optimized |
| J | 출력 포트 mode 1 power |a_out|² (optimizer 단위) | fom(x) |
| g | adjoint gradient ∂J/∂ρ | g_start |
| v, s | gate 방향(g/|g|), FD step | v, steps |
| α | 손 step 크기 | one_step |
| P_in | 입력면 mode 1 power (참조 run) | input_power |
| T_mode1, T_total | 새 run의 mode 1 power / P_in, 전체 flux / P_in | report |
가정과 유효 범위: 2D Ez(TE), 굴절률 Si 3.4 / SiO2 1.44, 폭 0.5 µm, 해상도 10(픽셀 100 nm), 단일 주파수. 설계 격자 11 × 11은 Yee 격자와 별개다. 제작 제약(최소 선폭, 이진화)은 없다.
4. 직접 실행하기: step 크기 하나만 비교하기
먼저 전체 스크립트와 공통 helper를 같은 폴더에 두세요. bend_inverse.py와 blogfig.py가 필요합니다. Meep 1.33.0, NLopt, autograd가 준비된 환경에서 원본을 한 번 실행합니다. 기록된 실행 시간은 단일 코어 약 29초입니다.
python bend_inverse.py
이번에 볼 출력은 one manual step: 한 줄입니다. 원본은 같은 출발점과 같은 정규화 gradient 방향에서 α = 0.2, 1, 3, 8을 비교합니다. 각 설계는 앞선 결과에 이어서 움직인 것이 아니라, 모두 균일한 0.5에서 한 번씩 이동한 결과입니다.
# 원본 전체 코드에서 발췌: 이 조각만 단독 실행하지 않습니다.
x_try = np.clip(x_start + alpha * v, 0, 1)
한 가지 실험: 원본의 for alpha in (0.2, 1.0, 3.0, 8.0):에서 마지막 값만 4.0으로 바꿔 다시 실행하세요. α = 4와 8에서 J와 밀도 포화가 어떻게 달라질지 먼저 적고, 출력과 06_step_mma.png로 확인합니다. 다른 파라미터와 MMA 평가 횟수는 그대로 둡니다.
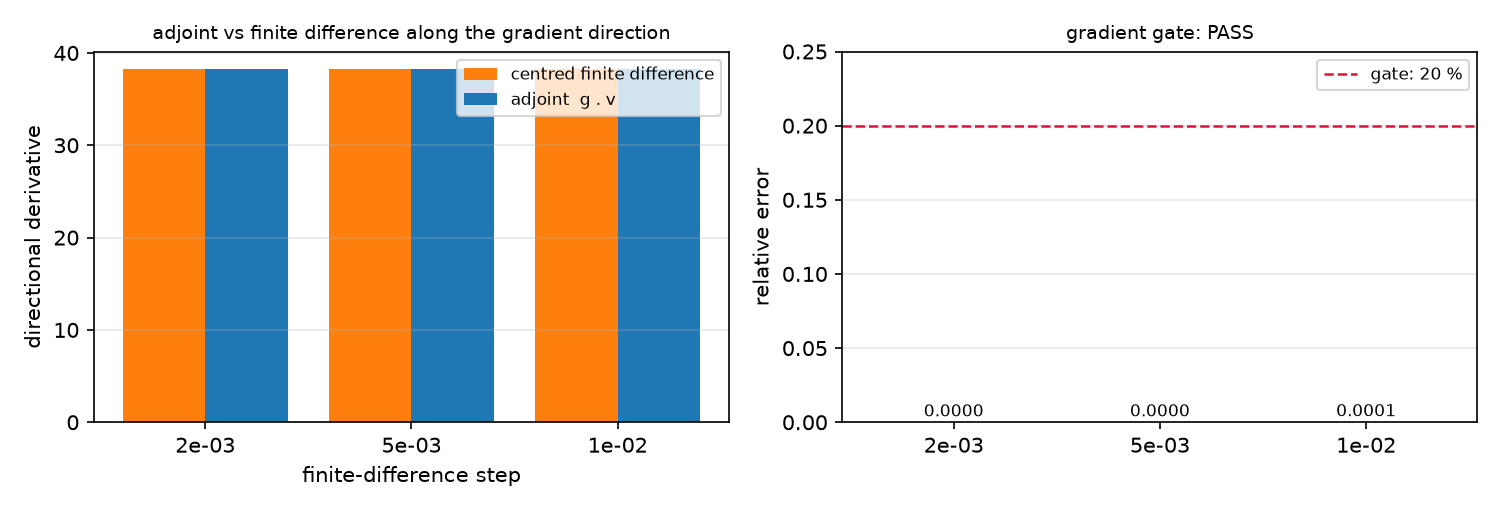
실행 전 확인: gradient gate가 PASS인지 먼저 봅니다. 이 예제는 세 유한차분 step 모두 상대오차가 0.01% 이내였습니다. gate가 HOLD이면 optimizer 결과 해석을 멈추고 원인을 확인하세요. 입력 mode 1 비율이 0.95 아래라면 source부터 점검합니다.
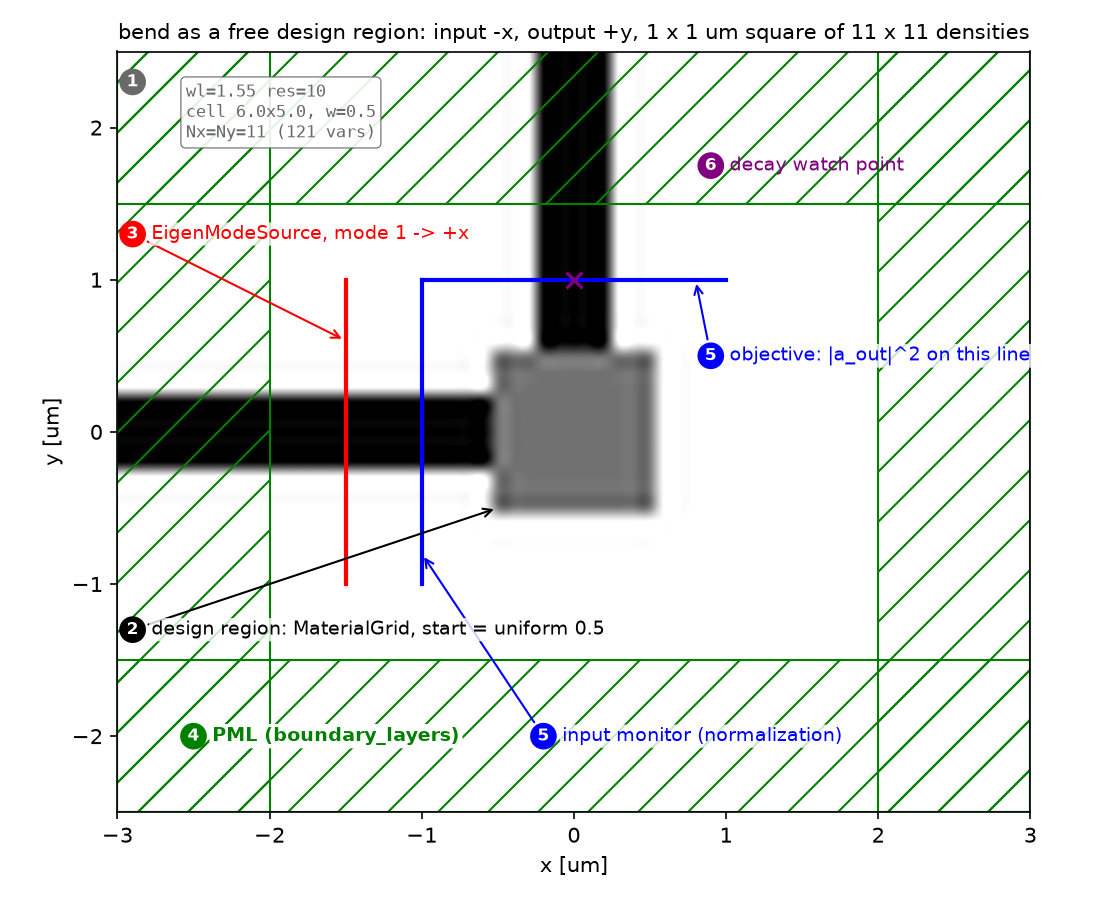
시뮬레이션 설계도·파라미터·source 검증
| 파라미터 | 값 | 왜 이 값인가 | 바꾸면 |
|---|---|---|---|
| 셀, 해상도 | 6 × 5 µm, res 10 | 강의 week 10과 같다. 한 run이 2~3 s | res 20이면 결과 해석의 해상도 표처럼 값이 바뀐다 |
| 설계 영역 | 1 × 1 µm, 11 × 11 | 도파관 폭의 2배. 변수 121개 | 1.5 × 1.5면 변수 256개, 시간도 비례 |
| 초기값 | 균일 0.5 | 내부점이라 gate를 바로 잴 수 있고 방향 편향이 없다 | 0/1 초기값이면 08편처럼 clip 처리 필요 |
| source | mode 1, fwidth 0.12 fcen | 좁은 대역. 단일 주파수 목적함수에 맞춘다 | 넓히면 펄스가 짧아져 GIF에 좋지만 forward run은 그대로 |
| monitor | 출력 y = 1, 폭 2 µm | 설계 영역에서 0.5 µm 떨어진 곳 | 설계 영역에 붙이면 근접장이 mode 분해에 섞인다 |
| gate steps | 2e-3, 5e-3, 1e-2 | 08편과 같다 | — |
| 손 step α | 0.2, 1, 3, 8 | 08편(0.05~2)보다 넓다. 포화를 보기 위해 | — |
maxeval |
5 | 수업용 smoke test | 수렴을 보려면 수십 회 + 이진화 |
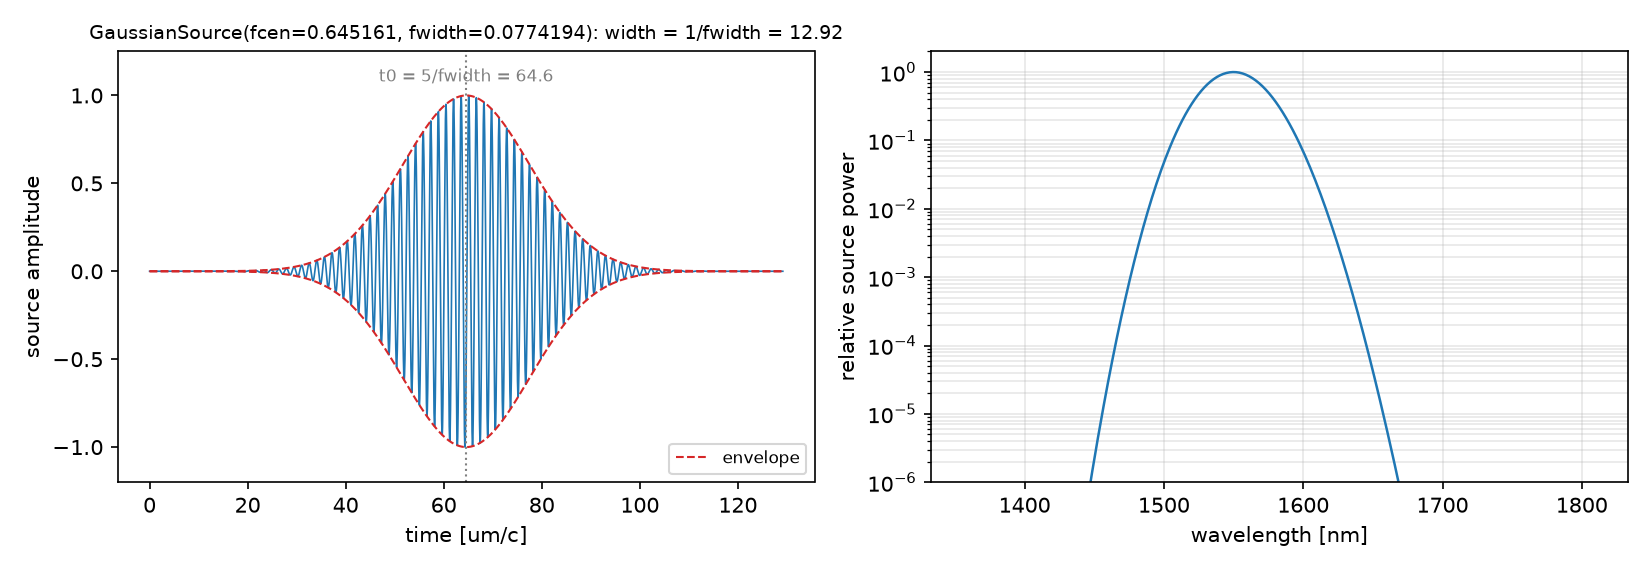
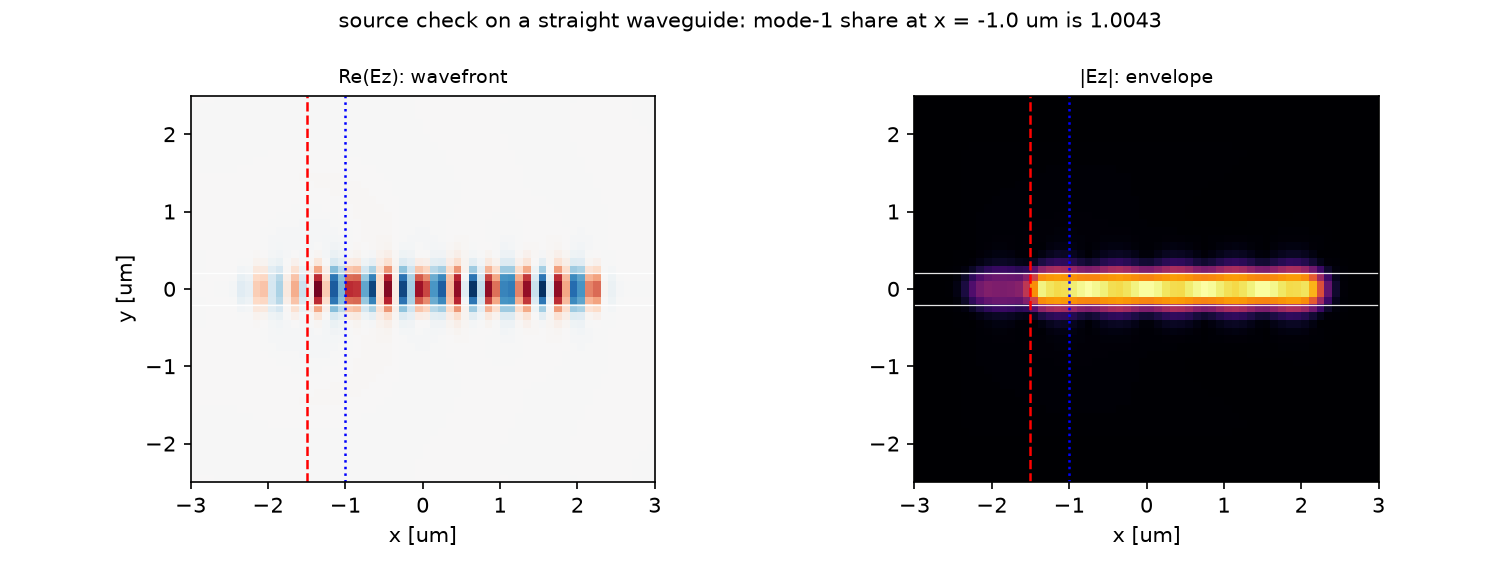
강의 노트북과의 차이: 파라미터와 수치(mode 1 비율 1.0043, gate 0.0000/0.0000/0.0001, 손 step 16.7/118.9/176.2/235.5, MMA 4.31 → 222.4, 검증 0.0154 → 0.7801)는 강의 week 10과 같다. 강의는 Meep 1.34, 여기는 1.33인데 소수 넷째 자리까지 같다. 이 글이 더한 것은 해상도 20에서의 재측정(결과 해석 수렴성)과 GIF 두 개, 단계 번호가 붙은 설계도다.
코드 7단계 해설: 각 줄의 역할과 흔한 함정
읽는 순서: 단위·파라미터 → 재료·구조 → source → Simulation·경계 → monitor → 실행·종료 → 후처리. 08편과 같은 구조이고, 달라지는 줄은 ⑤의 목적함수와 ⑦의 정규화뿐이다.
① 단위와 파라미터 — 어떤 숫자를 고정하는가
wl, fcen, fwidth = 1.55, 1 / 1.55, 0.12 / 1.55
Si, SiO2 = mp.Medium(index=3.4), mp.Medium(index=1.44)
RES, SX, SY, DPML, W = 10, 6.0, 5.0, 1.0, 0.5
SRC_X, MON_IN_X, MON_OUT_Y = -1.5, -1.0, 1.0        # source, input monitor, objective monitor
D, NX, NY = 1.0, 11, 11                                # design square and its grid (121 densities)
x_start = 0.5 * np.ones(NX * NY)                        # uniform grey: interior point, no bias
- 무엇: 셀, 도파관, 설계 격자, 세 평면(source, 입력 monitor, 출력 monitor)의 위치.
- 왜: 입력 monitor는 source와 설계 영역 사이에 둔다. 참조 run에서 여기서 잰 mode 1 power가 모든 투과율의 분모다. 출력 monitor는 설계 영역에서 0.5 µm 띄운다.
- 틀리면: 설계 격자 11 × 11을 Yee 격자(res 10이면 1 µm에 10칸)와 혼동하면 “픽셀 하나 = 격자 하나”로 착각한다.
MaterialGrid는 설계 격자를 Yee 격자에 보간한다.
② 재료와 구조 — 무엇이 어디에 있는가
def waveguide_blocks():
    return [mp.Block(center=mp.Vector3(-SX / 4, 0), size=mp.Vector3(SX / 2, W), material=Si),    # input, from -x
            mp.Block(center=mp.Vector3(0, SY / 4), size=mp.Vector3(W, SY / 2), material=Si)]     # output, to +y

design_variables = mp.MaterialGrid(mp.Vector3(NX, NY), SiO2, Si, grid_type="U_MEAN", do_averaging=False)   # contract 1
design_region = mpa.DesignRegion(design_variables, volume=mp.Volume(center=mp.Vector3(), size=mp.Vector3(D, D)))
geometry = waveguide_blocks() + [mp.Block(center=design_region.center, size=design_region.size, material=design_variables)]
- 무엇: 고정된 Si 도파관 두 개와, 원점의 정사각형
MaterialGrid. 최적화는 정사각형 안만 바꾼다. - 왜: 두 도파관이 설계 영역의 왼쪽 변과 위쪽 변에 닿는다. 설계 영역이 둘을 어떻게 이을지는 gradient가 정한다.
- 틀리면: 도파관 블록이 설계 영역과 겹치면 겹친 곳의 유전율은 나중 객체가 이긴다. 설계 영역을 마지막에 두어야 밀도가 반영된다.
③ Source — 빛을 어떻게 넣는가
sources = [mp.EigenModeSource(mp.GaussianSource(fcen, fwidth=fwidth), eig_band=1, direction=mp.NO_DIRECTION,
                              eig_kpoint=mp.Vector3(1, 0, 0), size=mp.Vector3(0, 2), center=mp.Vector3(SRC_X, 0))]
adjoint_sources = opt.adjoint_sources[0]      # one EigenModeSource at the OUTPUT monitor, made by opt
- 무엇: 04편과 같은
EigenModeSource. adjoint source는OptimizationProblem이 출력 monitor 자리에 만든다. - 왜: 목적함수가 mode 1 진폭이므로 adjoint source도 mode 1 모양이다. 08편에서는 평면파였다.
- 틀리면:
direction=mp.NO_DIRECTION에eig_kpoint를 빼면 모드 방향이 정해지지 않는다. 참조 run의 mode 1 비율이 1에서 멀면 여기부터 의심한다.
④ Simulation과 경계 — 계산 상자와 PML
common = dict(resolution=RES, cell_size=mp.Vector3(SX, SY), boundary_layers=[mp.PML(DPML)], sources=sources, eps_averaging=False)
sim = mp.Simulation(geometry=geometry, **common)
stop_cond = mp.stop_when_fields_decayed(30, mp.Ez, mp.Vector3(0, MON_OUT_Y), 1e-5)
- 무엇: 네 변 모두 PML 1 µm. 종료 감시점은 출력 monitor 중앙.
- 왜: forward, adjoint, FD, 검증, 해상도 확인이 모두 같은
common을 쓴다. 해상도만 바꿔 끼운다. - 틀리면:
eps_averaging을 기본값으로 두면 계약 1이 깨진다. 설계 영역 안에서는do_averaging=False, 밖에서는eps_averaging=False가 각각 담당한다.
⑤ Monitor — 목적함수
out_mode = mpa.EigenmodeCoefficient(sim, mp.Volume(center=mp.Vector3(0, MON_OUT_Y), size=mp.Vector3(2, 0)), mode=1)
opt = mpa.OptimizationProblem(simulation=sim, objective_functions=lambda a: npa.abs(a) ** 2,
                              objective_arguments=[out_mode], design_regions=[design_region], fcen=fcen, df=0, nf=1)
-
무엇: 출력 monitor 선 위의 mode 1 진폭 a_out을 인자로, a_out ²를 목적함수로. - 왜: 08편의
kpoint_func와eig_vol이 없다. 도파관 모드는 monitor 폭 전체에서 풀면 되고 방향은 monitor의 법선이다. 바뀐 줄은 이 두 줄뿐이다. - 틀리면: monitor 폭 2 µm가 도파관(0.5 µm)보다 충분히 넓어야 모드 꼬리를 담는다. 폭을 0.5로 줄이면 a_out이 작아지고 gradient도 그만큼 틀어진다.
⑥ 실행 — forward, adjoint, gate, 한 걸음, MMA
f, dJ = opt([x], need_gradient=True)                   # forward + adjoint: J and dJ/drho for all 121 pixels

v = g_start / np.linalg.norm(g_start)                   # gate: gradient direction, x_start is already interior
fd = (fom(x_start + s * v) - fom(x_start - s * v)) / (2 * s)
ok = abs(g_start @ v - fd) / abs(fd) <= 0.20

x_try = np.clip(x_start + alpha * v, 0, 1)              # one step by hand, alpha in (0.2, 1, 3, 8)

solver = nlopt.opt(nlopt.LD_MMA, NX * NY); solver.set_lower_bounds(0); solver.set_upper_bounds(1)
solver.set_max_objective(nlopt_objective); solver.set_maxeval(5)
x_optimized = design_history[int(np.argmax(history))]  # keep the best evaluated design
- 무엇: 08편과 같은 순서. gate, 손 step, MMA 5회, 최고 평가 보관.
- 왜: 초기값이 0.5 균일이라 clip 없이 바로 gate를 잰다. 08편에서 0/1 baseline을 0.02~0.98로 밀어 넣던 단계가 빠진다.
- 틀리면:
solver.optimize가 돌려주는 x는 마지막 평가가 아니라 MMA 내부 상태다. 보고할 설계는 history에서 고른다.
⑦ 후처리 — 계약 4, 별도 검증과 정규화
def modal_power(weights, res=RES):
    s = mp.Simulation(geometry=geometry_with(weights), **dict(common, resolution=res))      # a NEW simulation
    mon = s.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(0, MON_OUT_Y), size=mp.Vector3(2, 0)))
    s.run(until_after_sources=stop_cond)
    mode1 = abs(s.get_eigenmode_coefficients(mon, [1], direction=mp.Y).alpha[0, 0, 0]) ** 2
    return mode1, mp.get_fluxes(mon)[0]

T_mode1 = mode1 / input_power          # input_power: mode-1 power at x = -1 um in the straight-waveguide run
- 무엇: 최종 설계를 새
Simulation에 넣고 출력 포트의 mode 1 power와 전체 flux를 다시 잰 뒤 P_in으로 나눈다. 같은 함수에 res = 20을 넣어 한 번 더 잰다. - 왜: optimizer 내부 J를 P_in으로 나누면 1.056이 나온다. 단위가 다른 숫자다. 투과율이라 부를 수 있는 값은 이 함수가 돌려주는 것뿐이다.
- 틀리면: res 20 검사에서 분모도 res 20의 참조 run으로 다시 재야 한다. 분자만 바꾸면 해상도 차이가 아니라 정규화 차이를 보게 된다.
함정: mpa.EigenmodeCoefficient의a ²와 get_eigenmode_coefficients의α ²는 같은 물리량이지만 정규화 관례가 다르다. 둘을 섞어 비율을 만들면 1이 넘는 투과율이 나온다. 분자와 분모를 같은 함수로 재는 것이 계약 4의 실질이다.
5. 결과 해석하기: 좋아진 숫자가 무엇을 뜻할까?
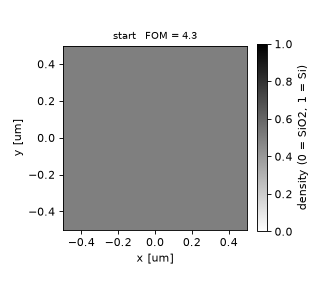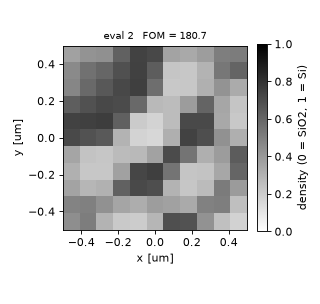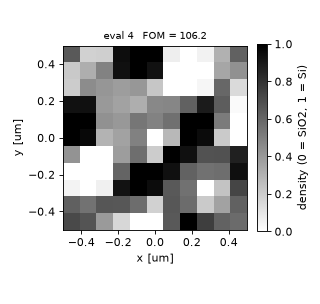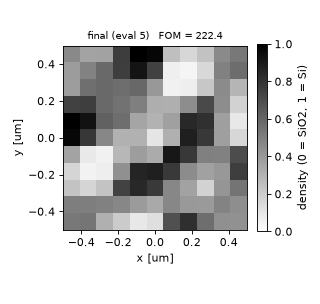
이 예제에서는 α가 8까지 커져도 J가 올랐습니다. 그렇다고 큰 step이 언제나 유리한 것은 아닙니다. 08편은 큰 step에서 값이 떨어졌고, 이 예제의 MMA도 4.31 → 180.7 → 4.5 → 106.2 → 222.4처럼 오르내렸습니다. 그래서 평가한 설계 중 가장 높은 J를 낸 5회차를 보관합니다.
| 확인할 값 | 출발점 | 보관한 설계 |
|---|---|---|
| 새 run의 mode 1 투과율 | 0.0154 | 0.7801 |
| 새 run의 전체 flux / 입력 mode 1 power | 0.1165 | 0.8040 |
두 열은 같은 참조 입력 power로 정규화했습니다. 최종 T_total과 T_mode1의 차이 약 0.024는 출력면을 지났지만 mode 1로 잡히지 않은 몫입니다.
J = 222.4를 투과율로 읽지 않기. 이를 입력 power 210.6으로 나누면 1.056이 됩니다. 두 수의 정규화 관례가 다르기 때문입니다. 분자와 분모를 같은 함수로 다시 측정한 투과율이 0.7801입니다.
이 설계를 얼마나 믿을 수 있을까?
gradient gate 통과는 현재 계산 설정에서 미분이 맞는지 확인합니다. 최적화 수렴, 해상도 수렴, 제작 가능성까지 보장하지는 않습니다.
| 검사 | 이번 결과 | 의미 |
|---|---|---|
| Gradient gate | 세 step 모두 PASS, 오차 0.01% 이내 | 유한차분과 adjoint가 일치 |
| 같은 121개 밀도, 해상도 10 → 20 | T_mode1 0.7801 → 0.6391 | 해상도 수렴이 확인되지 않음 |
| 밀도와 평가 횟수 | 회색조 119/121개, MMA 5회 | 이진 재료 설계나 수렴한 최적해가 아님 |
해상도 검사에서는 설계 밀도를 그대로 두고 Yee 격자를 세분화하며, 분모인 참조 입력 power도 새 해상도에서 다시 잽니다. 이번 결과는 adjoint 절차를 배우는 짧은 시연입니다. 다른 파장·편광·3D 성능이나 제조 성능은 이 수치에서 알 수 없습니다.
시간에 따른 빛과 설계의 변화
원본 결과 그림·수치표 자세히 보기
| step | FD | adjoint g·v | 상대오차 |
|---|---|---|---|
| 2e-3 | 38.2396 | 38.2395 | 0.0000 |
| 5e-3 | 38.2405 | 38.2395 | 0.0000 |
| 1e-2 | 38.2436 | 38.2395 | 0.0001 |
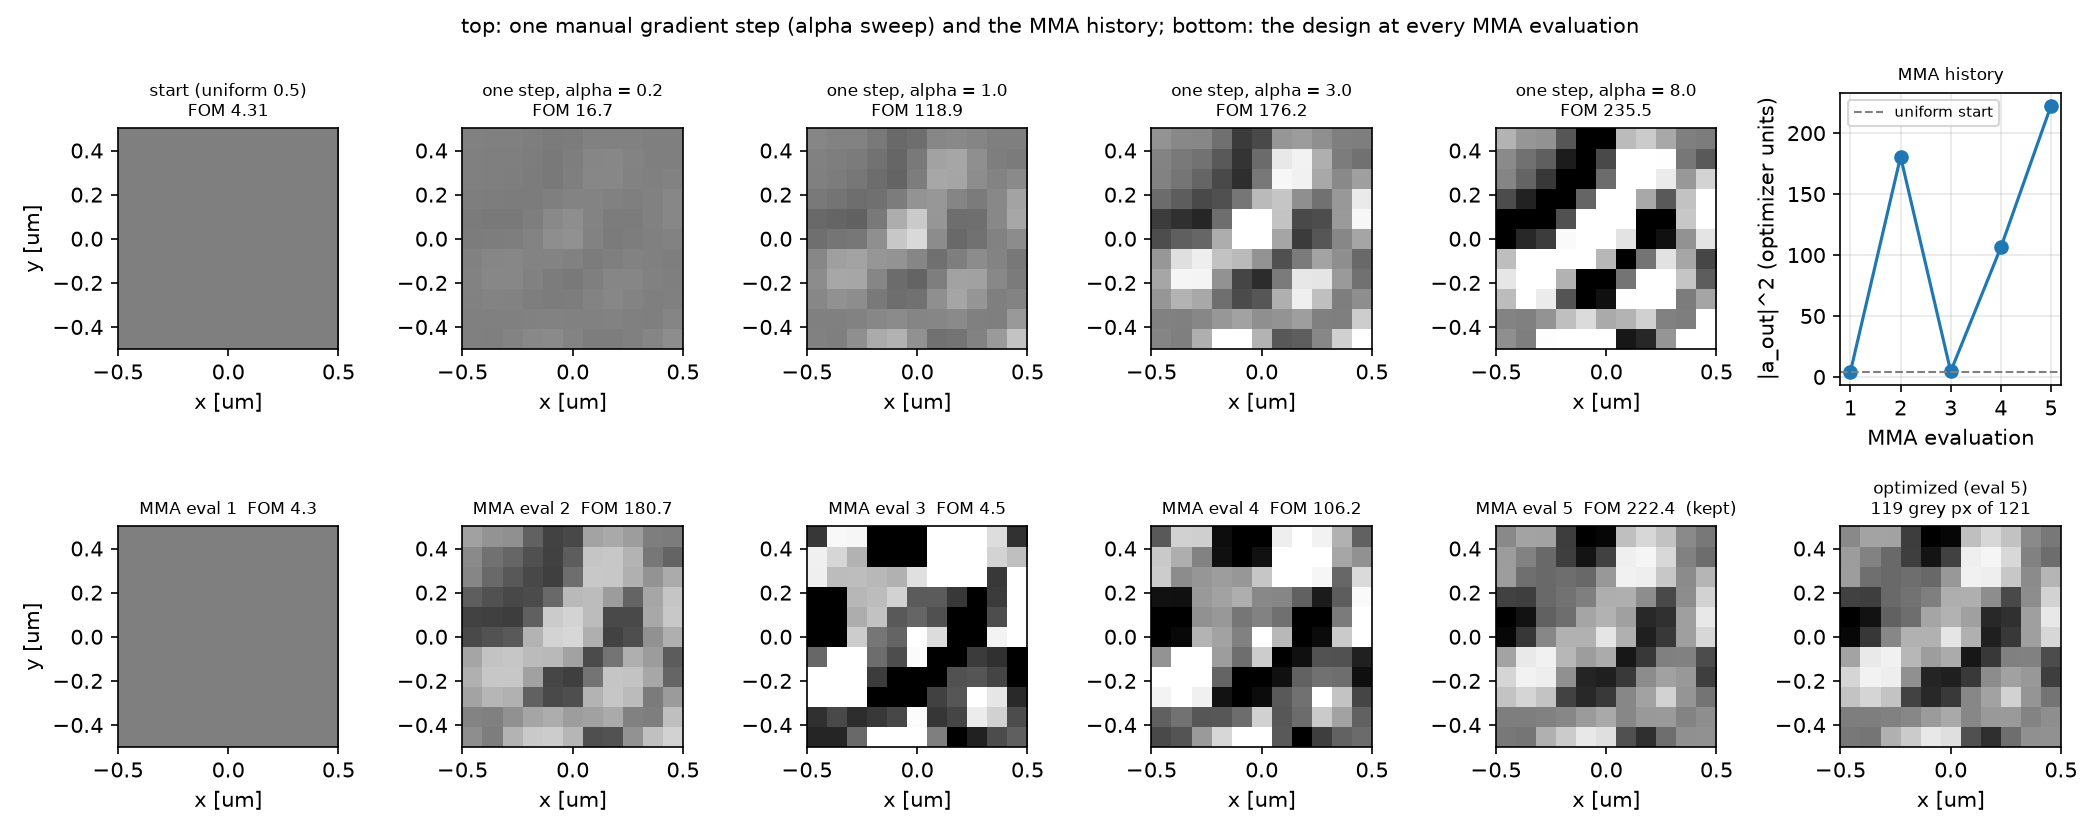
| α | J | J / J_start |
|---|---|---|
| 0.2 | 16.66 | 3.9 |
| 1.0 | 118.92 | 27.6 |
| 3.0 | 176.24 | 40.9 |
| 8.0 | 235.54 | 54.7 |
08편에서는 α = 2에서 목적함수가 떨어졌다. 여기서는 α = 8까지 오른다. 출발점이 균일 0.5라 각 픽셀은 “올릴지 내릴지”만 정해지면 되고, 끝까지 밀어 clip되어도 방향이 맞으면 J는 오른다. 08편의 출발점은 이미 괜찮은 설계였고 거기서 멀리 가면 구조가 망가졌다. 좋은 step size는 문제마다 다르다. optimizer가 step을 스스로 조절해야 하는 이유다.
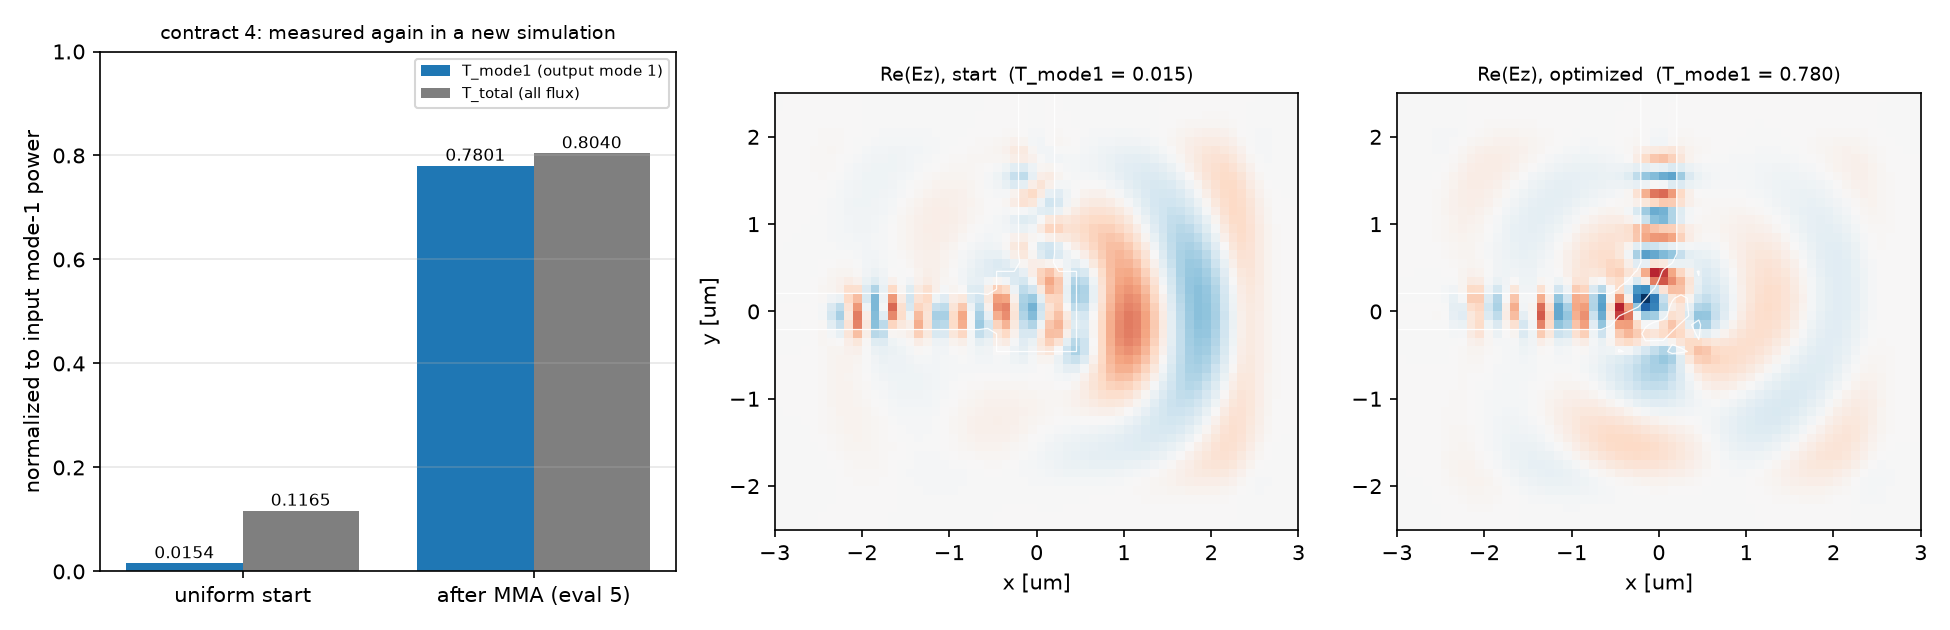
| 설계 | mode 1 power | 전체 flux | T_mode1 | T_total |
|---|---|---|---|---|
| 균일 0.5 출발점 | 3.247 | 24.546 | 0.0154 | 0.1165 |
| 최적화 (MMA eval 5) | 164.29 | 169.33 | 0.7801 | 0.8040 |
T_total과 T_mode1의 차이(0.024)는 출력면을 지났지만 mode 1이 아닌 몫이다. 05편의 진단식과 같은 구분이다. optimizer 내부 J = 222.4를 P_in = 210.6으로 나누면 1.056이다. 그 숫자는 투과율이 아니다.
예측과 비교
| 물리량 | 내 예측 (처음의 예측) | 시뮬레이션 | 판정 |
|---|---|---|---|
| 입력면 mode 1 비율 | 0.98~1.02 | 1.0043 | ✅ |
| 출발점 T_mode1 | 몇 % | 0.0154 | ✅ |
| gradient 패턴 | 대각선 띠가 양수 | 중앙 음수, 두 도파관 연장선이 양수. 대각선은 큰 step 뒤에야 나타남 | ❌ |
| gate 상대오차 | 1% 안 | 0.00%, 0.00%, 0.01% | ✅ |
| 손 step α | 오르다 꺾임 | α = 8까지 계속 상승 | ❌ |
| MMA 5회 뒤 T_mode1 | 0.5~0.7 | 0.780 | ❌ (예측보다 높음) |
| 해상도 20에서 같은 설계 | 몇 % 차이 | 0.780 → 0.639 | ❌ |
| 회색조 픽셀 | 절반 이상 | 119 / 121 | ✅ |
예측이 네 개 틀렸고, 틀린 것이 이 글의 내용이다. 첫째, 날것 gradient는 거울을 그리지 않는다. 첫 미분이 말하는 것은 “중앙의 밀도를 낮추고 두 도파관 연결부의 밀도를 높여라”이고, 대각선은 여러 픽셀이 포화한 뒤에 나타나는 구조다. 둘째, step size의 직관은 문제를 넘어 옮겨지지 않는다. 셋째, 다섯 번으로 0.78까지 간 것은 설계 자유도가 큰 덕이지 설계가 좋아서가 아니다. 넷째, 해상도 20에서 0.64로 떨어진 것은 이 설계가 res 10의 격자에 맞춰진 설계라는 뜻이다.
수렴성
| 변수 | 값 | T_mode1 | T_total | 비고 |
|---|---|---|---|---|
| 해상도 | 10 | 0.7801 | 0.8040 | 최적화에 쓴 해상도 |
| 해상도 | 20 | 0.6391 | 0.6870 | 같은 11 × 11 밀도, 분모도 res 20 참조 run |
| gate step | 2e-3 / 5e-3 / 1e-2 | FD 38.240 / 38.241 / 38.244 | — | 세 step 모두 adjoint 38.240과 0.01% 안 |
해상도 10에서 Si 안의 파장은 456 nm이고 격자 간격은 100 nm다. 파장당 4.5칸은 Meep 문서의 권장(8칸 이상)에 못 미친다. 회색조 픽셀이 119개라 유전율이 매끄럽게 변하는 설계인데, 그 보간이 Yee 격자에 어떻게 얹히는지가 해상도에 따라 다르다. res 20에서 다시 최적화하면 다른 설계가 나온다. 별도로 표시한 해상도 검사 외의 최적화 결과는 res 10에서의 값이다.
주장할 수 있는 것 / 없는 것
- 할 수 있는 것: 이 셀, 해상도 10, 단일 주파수에서 adjoint gradient는 유한차분과 0.01% 안에서 같다. 균일 0.5에서 다섯 번의 MMA 평가로 출력 mode 1 투과율이 0.015에서 0.780으로 올랐고, 그 값은 별도 run으로 재확인됐다. 08편의 절차는 목적함수를 바꿔도 그대로 쓰인다.
- 할 수 없는 것: “0.78짜리 bend를 설계했다”. 121개 중 119개가 회색조라 물리적 재료가 아니다. 해상도 20에서 0.64다. maxeval 5는 수렴이 아니다. 최소 선폭 제약이 없어 이진화하면 값이 달라진다. 다른 파장, 다른 편광, 3D에서의 값.
문제가 생겼을 때: 증상과 점검 위치
| 증상 | 원인 | 고치는 법 |
|---|---|---|
| 투과율이 1을 넘음 | optimizer 내부 J를 P_in으로 나눔 | 분자와 분모를 같은 함수(get_eigenmode_coefficients)로 |
| mode 1 비율이 0.9 아래 | source 폭이 모드 꼬리를 못 담거나 eig_kpoint 누락 |
참조 run의 field를 먼저 보고 source 폭 2 µm 확인 |
| gate HOLD | 초기값이 0/1 경계이거나 랜덤 방향 | 내부점, gradient 방향(08편 §6) |
| 손 step에서 값이 떨어짐 | 문제에 따라 정상 | 꺾이는 α를 기록하고 optimizer에 맡김 |
| MMA가 중간에 추락 | 신뢰영역 과대 | 정상 동작. 최고 평가를 보관 |
| 해상도를 올리니 값이 다름 | 설계가 격자에 맞춰짐 | 목표 해상도에서 최적화하거나 필터로 선폭 제한 |
| 회색조 설계를 소자로 해석 | 이진화·선폭 제약 없음 | 필터·투영·β 스케줄(공식 adjoint 예제 02 이후) |
6. 확인하기: 두 가지를 설명할 수 있나요?
1. Forward와 adjoint는 각각 어디에서 시작하며, gradient는 무엇을 바꾸라고 하나요?
Forward는 왼쪽 입력 도파관의 mode 1 source에서 시작합니다. Adjoint는 출력 mode 1 목적함수에서 유도되어 위쪽 출력 포트에 생긴 source로 별도 계산합니다. 두 계산으로 얻은 gradient는 설계 영역의 121개 밀도를 현재 상태에서 어느 방향으로 바꾸면 J가 늘어나는지 알려 줍니다. 첫 gradient 자체가 최종 도파관 모양은 아닙니다.
2. J = 222.4이고 투과율이 0.7801인데, 왜 완성된 소자라고 할 수 없나요?
J는 optimizer 내부 정규화 값이며 투과율은 새 run과 참조 run에서 다시 측정한 전력의 비입니다. 투과율도 해상도를 20으로 올리면 0.6391로 달라집니다. 설계는 119개 회색조 픽셀을 포함하고 평가도 5회뿐입니다. 해상도·최적화 수렴과 최소 선폭·이진화 검증이 더 필요합니다.
7. 참고 자료와 전체 코드
English summary
- What: post 05 steered a 90° bend with one number, the radius. Here the corner is a 1 × 1 µm square opened as a free design region of 11 × 11 densities (SiO2 to Si), and the adjoint gradient fills it. The contract is the one from post 08; only the objective changes, from a diffraction order to the mode-1 power at the output port.
- Result: the source puts 100.4 % of its flux into mode 1. The gradient passes the gate with 0.00 %, 0.00 %, 0.01 % error. Unlike post 08, one hand-made step keeps rising as α grows (3.9×, 28×, 41×, 55×) because pixels saturate at 0/1. Five MMA evaluations lift the internal objective 52×. Measured again in a fresh simulation and normalized to the input mode-1 power, the bend transmission goes from 0.015 to 0.780 (total flux through the port: 0.117 to 0.804). At twice the resolution the same design gives 0.639.
- Takeaway: the four steps transfer unchanged when the objective changes. What does not transfer is intuition about step size: whether a gradient step overshoots depends on the problem. The optimizer’s internal number is not a transmission (it even exceeds the input power), 119 of 121 pixels are still grey, and the design is not converged in resolution. This is a smoke test, not a device.
- Code: full script at the bottom, ~29 s on one core.
처음 세웠던 예측과 추가 실험 아이디어
결과 보기 전에 맞춰보기
| 물리량 | 내 예측 | 근거 |
|---|---|---|
| 입력면 mode 1 비율 | 0.98~1.02 | 04편에서 EigenModeSource는 단일 모드를 넣었다 |
| 균일 0.5 출발점의 T_mode1 | 몇 % | 회색 블록은 도파관이 아니다. 빛은 직진해서 새어 나간다 |
| gradient 패턴 | 입력과 출력을 잇는 대각선 띠가 양수 | 45° 거울이 가장 단순한 bend다 |
| gate 상대오차 | 1% 안 | 08편 0.7% |
| 손 step α | 오르다 꺾임 | 08편과 같은 선형 근사의 한계 |
| MMA 5회 뒤 T_mode1 | 0.5~0.7 | 자유도 121, 05편 sharp bend 0.20보다는 높을 것 |
| 해상도 20에서 같은 설계 | 몇 % 차이 | 설계는 격자에 고정됐으니 유전율 분포는 같다 |
| 회색조 픽셀 | 절반 이상 | 5회로는 포화하지 않는다 |
판정 기준: gate 상대오차 > 20%면 HOLD. mode 1 비율이 0.95 아래면 source부터 다시. T_mode1 > T_total이면 분해 오류.
| 바꿀 것 | 예상 변화 | 확인할 수치 |
|---|---|---|
| 설계 영역 1 × 1 → 1.5 × 1.5 µm | 변수 256개, 시간 2배 | T_mode1, 회색조 수 |
| 초기값을 05편의 사분원 bend 모양으로 | 출발점 T가 0.9 근처, gradient는 작음 | J_start, gate, 5회 뒤 변화 |
maxeval 5 → 30 |
투과율이 어디서 정체하는지 | history, 회색조 수 |
| res 20에서 처음부터 최적화 | 다른 설계, res 10과 비교 | 두 해상도의 T_mode1 |
목적함수를 두 주파수 평균으로 (nf=2) |
대역폭 대 피크 trade-off | 각 주파수의 T_mode1 |
전체 Python 코드
code/bend_inverse.py 전체 (클릭하여 펼치기)
"""Meep Example 09 - Waveguide bend inverse design (adjoint), with the same four-step contract as post 08.

Post 05 turned a 90-degree bend with ONE design variable (the radius). Here the corner is a 1 x 1 um square
opened as a free design region (11 x 11 densities, SiO2..Si) and the adjoint gradient fills it. Only the
objective changes: not a diffraction order but the guided mode-1 power at the output port.
  1. differentiability: eps_averaging=False, MaterialGrid do_averaging=False
  2. gradient gate: adjoint gradient vs centred finite differences along the gradient direction (interior point)
  3. a short MMA run (maxeval 5): a smoke test, not a converged design
  4. verification in a FRESH simulation with get_eigenmode_coefficients, normalized by the input mode-1 power
Plus: source check on a straight waveguide, forward field of uniform and random starts, adjoint field,
raw gradient, one manual step, a resolution check of the final design, two GIFs.

Run:  python bend_inverse.py      (~1 min on one core)
Out:  00_source.png, 01_layout.png, 02_source_check.png, 03_fields.png, 04_gradient.png, 05_gate.png,
      06_step_mma.png, 07_verify.png, 08_anim_optimized.gif, 09_anim_design.gif, result.json  (-> ../assets/09/)
"""
import json
import os
import sys
import time

import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import animation
import meep as mp
import meep.adjoint as mpa
import nlopt
from autograd import numpy as npa

sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))
from blogfig import Label, animate_fields, annotated_layout, record_frames, source_figure   # noqa: E402

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, "..", "assets", "09")
os.makedirs(OUT, exist_ok=True)
t_all = time.time()
np.random.seed(20260820)

# ---------------------------------------------------------------- (1) units & parameters (course week 10)
wl = 1.55
fcen = 1 / wl
fwidth = 0.12 * fcen
Si, SiO2 = mp.Medium(index=3.4), mp.Medium(index=1.44)
RES = 10
SX, SY = 6.0, 5.0
DPML = 1.0
W = 0.5                                   # waveguide width
SRC_X, SRC_SIZE = -1.5, 2.0               # EigenModeSource on the input waveguide
MON_IN_X = -1.0                           # input-power monitor (between source and design region)
MON_OUT_Y = 1.0                           # objective monitor on the output waveguide
D = 1.0                                   # design region side
NX = NY = 11                              # design grid: 11 x 11 = 121 densities
EXTENT = [-0.5 * SX, 0.5 * SX, -0.5 * SY, 0.5 * SY]
DEXT = [-0.5 * D, 0.5 * D, -0.5 * D, 0.5 * D]

sources = [mp.EigenModeSource(mp.GaussianSource(fcen, fwidth=fwidth), eig_band=1, direction=mp.NO_DIRECTION,
                              eig_kpoint=mp.Vector3(1, 0, 0), size=mp.Vector3(0, SRC_SIZE), center=mp.Vector3(SRC_X, 0))]
common = dict(resolution=RES, cell_size=mp.Vector3(SX, SY), boundary_layers=[mp.PML(DPML)], sources=sources, eps_averaging=False)
stop_cond = mp.stop_when_fields_decayed(30, mp.Ez, mp.Vector3(0, MON_OUT_Y), 1e-5)


# ---------------------------------------------------------------- (2) geometry: input (-x) and output (+y) waveguides + design square
def waveguide_blocks():
    return [mp.Block(center=mp.Vector3(-SX / 4, 0), size=mp.Vector3(SX / 2, W), material=Si),
            mp.Block(center=mp.Vector3(0, SY / 4), size=mp.Vector3(W, SY / 2), material=Si)]


def geometry_with(weights):
    grid = mp.MaterialGrid(mp.Vector3(NX, NY), SiO2, Si, weights=np.asarray(weights).reshape(NX, NY), grid_type="U_MEAN", do_averaging=False)
    return waveguide_blocks() + [mp.Block(center=mp.Vector3(), size=mp.Vector3(D, D), material=grid)]


design_variables = mp.MaterialGrid(mp.Vector3(NX, NY), SiO2, Si, grid_type="U_MEAN", do_averaging=False)     # contract 1
design_region = mpa.DesignRegion(design_variables, volume=mp.Volume(center=mp.Vector3(), size=mp.Vector3(D, D)))
geometry = waveguide_blocks() + [mp.Block(center=design_region.center, size=design_region.size, material=design_variables)]

# ---------------------------------------------------------------- (4) simulation + (5) objective: output-port mode-1 power
sim = mp.Simulation(geometry=geometry, **common)
out_mode = mpa.EigenmodeCoefficient(sim, mp.Volume(center=mp.Vector3(0, MON_OUT_Y), size=mp.Vector3(2, 0)), mode=1)
opt = mpa.OptimizationProblem(simulation=sim, objective_functions=lambda a: npa.abs(a) ** 2, objective_arguments=[out_mode],
                              design_regions=[design_region], fcen=fcen, df=0, nf=1)
x_start = 0.5 * np.ones(NX * NY)          # uniform grey: an interior point, differentiable, no bias
opt.update_design([x_start])
# a throw-away copy only for the layout figure: plot2D draws flux monitors, mpa objectives it does not
sim_plot = mp.Simulation(geometry=geometry_with(x_start), **common)
sim_plot.add_flux(fcen, 0, 1, mp.FluxRegion(center=mp.Vector3(0, MON_OUT_Y), size=mp.Vector3(2, 0)))
sim_plot.add_flux(fcen, 0, 1, mp.FluxRegion(center=mp.Vector3(MON_IN_X, 0), size=mp.Vector3(0, 2)))
annotated_layout(
    sim_plot, os.path.join(OUT, "01_layout.png"), dpml=DPML, figsize=(7.4, 6.0), axis_step=1.0,
    title="bend as a free design region: input -x, output +y, 1 x 1 um square of 11 x 11 densities",
    params_text=f"wl={wl} res={RES}\ncell {SX}x{SY}, w={W}\nNx=Ny={NX} (121 vars)",
    params_xy=(-2.9, 2.3), pml_xy=(-2.5, -0.5 * SY + 0.5 * DPML), decay_point=(0, MON_OUT_Y), decay_text_xy=(0.9, 1.75),
    labels=[Label("design region: MaterialGrid, start = uniform 0.5", (-0.5, -0.5), (-2.9, -1.3), step=2, color="black"),
            Label("EigenModeSource, mode 1 -> +x", (SRC_X, 0.6), (-2.9, 1.3), step=3, color="red"),
            Label("objective: |a_out|^2 on this line", (0.8, MON_OUT_Y), (0.9, 0.5), step=5, color="blue"),
            Label("input monitor (normalization)", (MON_IN_X, -0.8), (-0.2, -2.0), step=5, color="blue")])
source_figure(fcen, fwidth, os.path.join(OUT, "00_source.png"), wl_scale=1000.0, wl_unit="nm", time_unit="um/c")


def run_dft_field(src_list, geometry_list):
    s = mp.Simulation(geometry=geometry_list, **dict(common, sources=src_list))
    dft = s.add_dft_fields([mp.Ez], fcen, 0, 1, center=mp.Vector3(), size=mp.Vector3(SX, SY))
    s.run(until_after_sources=stop_cond)
    field = s.get_dft_array(dft, mp.Ez, 0); eps = s.get_epsilon(); s.reset_meep()
    return field, eps


def contour(a, eps):
    xs = np.linspace(EXTENT[0], EXTENT[1], eps.shape[0]); ys = np.linspace(EXTENT[2], EXTENT[3], eps.shape[1])
    a.contour(xs, ys, eps.T, levels=[0.5 * (1.44 ** 2 + 3.4 ** 2)], colors="w", linewidths=0.6, alpha=0.9)


def show_design(a, weights, title):
    im = a.imshow(np.asarray(weights).reshape(NX, NY).T, origin="lower", extent=DEXT, cmap="gray_r", vmin=0, vmax=1, aspect="equal")
    a.set_title(title, fontsize=8); a.set_xlabel("x [um]")
    return im


# ---------------------------------------------------------------- source check: straight waveguide, mode-1 share at the input monitor
straight = [mp.Block(center=mp.Vector3(), size=mp.Vector3(mp.inf, W), material=Si)]
field_src, eps_src = run_dft_field(sources, straight)
s_in = mp.Simulation(geometry=straight, **common)
mon_in = s_in.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(MON_IN_X, 0), size=mp.Vector3(0, 2)))
s_in.run(until_after_sources=mp.stop_when_fields_decayed(30, mp.Ez, mp.Vector3(MON_IN_X, 0), 1e-5))
total_in = float(mp.get_fluxes(mon_in)[0])
input_power = float(abs(s_in.get_eigenmode_coefficients(mon_in, [1], direction=mp.X).alpha[0, 0, 0]) ** 2)
s_in.reset_meep()
print(f"source check: input flux {total_in:.5e}, mode-1 power {input_power:.5e}, mode-1 share {input_power / total_in:.4f}")
fig, ax = plt.subplots(1, 2, figsize=(10, 3.8))
lim = float(np.max(np.abs(field_src)))
ax[0].imshow(np.real(field_src).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-lim, vmax=lim, aspect="equal"); ax[0].set_title("Re(Ez): wavefront", fontsize=9)
ax[1].imshow(np.abs(field_src).T, extent=EXTENT, origin="lower", cmap="inferno", aspect="equal"); ax[1].set_title("|Ez|: envelope", fontsize=9)
for a in ax:
    contour(a, eps_src); a.axvline(SRC_X, color="red", lw=1.2, ls="--"); a.axvline(MON_IN_X, color="blue", lw=1.2, ls=":"); a.set_xlabel("x [um]")
ax[0].set_ylabel("y [um]")
fig.suptitle(f"source check on a straight waveguide: mode-1 share at x = {MON_IN_X} um is {input_power / total_in:.4f}", fontsize=10)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "02_source_check.png"), dpi=150); plt.close(fig)


def fom(x, need_gradient=False):
    """Objective = output-port mode-1 power |a_out|^2 in optimizer units (NOT normalized; see contract 4)."""
    f, dJ = opt([np.clip(x, 0, 1)], need_gradient=need_gradient)
    f = float(np.real(np.asarray(f).squeeze()))
    if not need_gradient:
        return f
    return f, np.squeeze(np.asarray(dJ))


# ---------------------------------------------------------------- forward fields: uniform vs random start; adjoint field
field_fwd, eps_fwd = run_dft_field(sources, geometry_with(x_start))
f_start, g_start = fom(x_start, need_gradient=True)
x_random = np.random.rand(NX * NY)
field_rand, eps_rand = run_dft_field(sources, geometry_with(x_random))
f_random = fom(x_random)
adjoint_sources = opt.adjoint_sources[0]
field_adj, eps_adj = run_dft_field(adjoint_sources, geometry_with(x_start))
print(f"forward: uniform-0.5 FOM = {f_start:.4f} (|grad| = {np.linalg.norm(g_start):.3e}); random start FOM = {f_random:.4f}; "
      f"adjoint sources: {len(adjoint_sources)} x {type(adjoint_sources[0]).__name__}")

fig, ax = plt.subplots(2, 4, figsize=(13, 6.4), gridspec_kw={"width_ratios": [0.55, 1, 1, 1]})
lim = max(np.max(np.abs(field_fwd)), np.max(np.abs(field_rand)))
for r, (weights, fld, eps, tag, val) in enumerate(((x_start, field_fwd, eps_fwd, "uniform 0.5", f_start), (x_random, field_rand, eps_rand, "random seed", f_random))):
    show_design(ax[r, 0], weights, f"design: {tag}\nFOM = {val:.3f}"); ax[r, 0].set_ylabel("y [um]")
    ax[r, 1].imshow(np.real(fld).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-lim, vmax=lim, aspect="equal"); ax[r, 1].set_title("forward Re(Ez)", fontsize=9)
    ax[r, 2].imshow(np.abs(fld).T, extent=EXTENT, origin="lower", cmap="inferno", aspect="equal"); ax[r, 2].set_title("forward |Ez|", fontsize=9)
    for a in ax[r, 1:3]:
        contour(a, eps); a.set_xlabel("x [um]")
la = float(np.max(np.abs(field_adj)))
ax[0, 3].imshow(np.real(field_adj).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-la, vmax=la, aspect="equal"); ax[0, 3].set_title("adjoint Re(Ez) (source at the output port)", fontsize=9)
ax[1, 3].imshow(np.abs(field_adj).T, extent=EXTENT, origin="lower", cmap="inferno", aspect="equal"); ax[1, 3].set_title("adjoint |Ez|", fontsize=9)
for a in ax[:, 3]:
    contour(a, eps_adj); a.set_xlabel("x [um]")
fig.suptitle("rows: uniform vs random start (forward); right column: the adjoint field of the uniform start", fontsize=10)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "03_fields.png"), dpi=150); plt.close(fig)

# ---------------------------------------------------------------- raw gradient on the 11 x 11 grid
g2 = g_start.reshape(NX, NY)
lim = float(np.max(np.abs(g2)))
fig, ax = plt.subplots(1, 3, figsize=(12, 3.8))
im0 = show_design(ax[0], x_start, "current design (uniform 0.5)"); plt.colorbar(im0, ax=ax[0], fraction=0.046)
im1 = ax[1].imshow(g2.T, origin="lower", extent=DEXT, cmap="RdBu_r", vmin=-lim, vmax=lim, aspect="equal"); ax[1].set_title("raw adjoint gradient dJ/d(density)\nred: more Si helps, blue: more SiO2 helps", fontsize=8); plt.colorbar(im1, ax=ax[1], fraction=0.046)
im2 = ax[2].imshow(np.abs(g2).T, origin="lower", extent=DEXT, cmap="viridis", aspect="equal"); ax[2].set_title("|gradient|: where the design matters most", fontsize=8); plt.colorbar(im2, ax=ax[2], fraction=0.046)
for a in ax[1:]:
    a.set_xlabel("x [um]")
ax[0].set_ylabel("y [um]")
fig.tight_layout(); fig.savefig(os.path.join(OUT, "04_gradient.png"), dpi=150); plt.close(fig)
print(f"gradient: max {g2.max():+.4e}, min {g2.min():+.4e}; positive pixels {int((g2 > 0).sum())}, negative {int((g2 < 0).sum())}")

# ---------------------------------------------------------------- contract 2: gradient gate (uniform 0.5 is already an interior point)
assert np.all((x_start > 0.02) & (x_start < 0.98))
v = g_start / np.linalg.norm(g_start)
adjoint_dd = float(np.dot(g_start, v))
steps = [2e-3, 5e-3, 1e-2]
gate_rows = []
for step in steps:
    fd = (fom(x_start + step * v) - fom(x_start - step * v)) / (2 * step)
    rel = abs(adjoint_dd - fd) / max(abs(fd), 1e-30)
    gate_rows.append({"step": step, "fd": fd, "adjoint": adjoint_dd, "rel_err": rel, "pass": bool(rel <= 0.20 and np.sign(fd) == np.sign(adjoint_dd))})
gradient_gate = all(r["pass"] for r in gate_rows)
print("gate: " + "; ".join(f"step {r['step']:.0e}: FD {r['fd']:.5e} vs adjoint {r['adjoint']:.5e}, rel {r['rel_err']:.4f} {'PASS' if r['pass'] else 'HOLD'}" for r in gate_rows)
      + f" -> gradient gate {'PASS' if gradient_gate else 'HOLD'}")
fig, ax = plt.subplots(1, 2, figsize=(10, 3.4))
idx = np.arange(len(steps))
ax[0].bar(idx - 0.2, [r["fd"] for r in gate_rows], width=0.4, color="tab:orange", label="centred finite difference")
ax[0].bar(idx + 0.2, [adjoint_dd] * 3, width=0.4, color="tab:blue", label="adjoint  g . v")
ax[0].set_xticks(idx); ax[0].set_xticklabels([f"{s:.0e}" for s in steps]); ax[0].set_xlabel("finite-difference step"); ax[0].set_ylabel("directional derivative")
ax[0].set_title("adjoint vs finite difference along the gradient direction", fontsize=9); ax[0].grid(axis="y", alpha=0.3); ax[0].legend(fontsize=8)
bars = ax[1].bar(idx, [r["rel_err"] for r in gate_rows], color=["tab:green" if r["pass"] else "tab:red" for r in gate_rows])
ax[1].axhline(0.20, ls="--", color="crimson", lw=1.2, label="gate: 20 %")
for b, r in zip(bars, gate_rows):
    ax[1].text(b.get_x() + b.get_width() / 2, r["rel_err"] + 0.004, f"{r['rel_err']:.4f}", ha="center", fontsize=8)
ax[1].set_xticks(idx); ax[1].set_xticklabels([f"{s:.0e}" for s in steps]); ax[1].set_ylim(0, 0.25); ax[1].set_ylabel("relative error")
ax[1].set_title(f"gradient gate: {'PASS' if gradient_gate else 'HOLD'}", fontsize=9); ax[1].grid(axis="y", alpha=0.3); ax[1].legend(fontsize=8)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "05_gate.png"), dpi=150); plt.close(fig)
if not gradient_gate:
    raise SystemExit("gradient gate HOLD: do not interpret optimizer results")

# ---------------------------------------------------------------- one manual step, then MMA (contract 3)
one_step = []
for alpha in (0.2, 1.0, 3.0, 8.0):
    x_try = np.clip(x_start + alpha * v, 0, 1)
    one_step.append((alpha, x_try, fom(x_try)))
print("one manual step: " + ", ".join(f"alpha {a} -> {f:.3f} ({f / f_start:.1f}x)" for a, _, f in one_step))

history, design_history = [], []


def nlopt_objective(x, grad):
    f, dJ = fom(x, need_gradient=True)
    if grad.size > 0:
        grad[:] = dJ
    history.append(f); design_history.append(np.array(x, copy=True))
    return f


solver = nlopt.opt(nlopt.LD_MMA, NX * NY)
solver.set_lower_bounds(np.zeros(NX * NY)); solver.set_upper_bounds(np.ones(NX * NY))
solver.set_max_objective(nlopt_objective); solver.set_maxeval(5)
solver.optimize(x_start.copy())
best_k = int(np.argmax(history))
x_optimized = design_history[best_k]                          # keep the best evaluated design (MMA may overshoot)
gray = int(np.sum((x_optimized > 0.02) & (x_optimized < 0.98)))
print("MMA (maxeval 5): " + ", ".join(f"eval {k + 1}: {f:.3f}" for k, f in enumerate(history)) + f"; best eval {best_k + 1} = {max(history):.3f} ({max(history) / history[0]:.1f}x); grayscale pixels {gray}/{NX * NY}")

fig, ax = plt.subplots(2, 6, figsize=(14, 5.6))
show_design(ax[0, 0], x_start, f"start (uniform 0.5)\nFOM {f_start:.2f}"); ax[0, 0].set_ylabel("y [um]")
for a, (alpha, x_try, f_try) in zip(ax[0, 1:5], one_step):
    show_design(a, x_try, f"one step, alpha = {alpha}\nFOM {f_try:.1f}")
ax[0, 5].plot(range(1, len(history) + 1), history, "o-", color="tab:blue"); ax[0, 5].axhline(f_start, ls="--", color="gray", lw=1, label="uniform start")
ax[0, 5].set_xticks(range(1, len(history) + 1)); ax[0, 5].set_xlabel("MMA evaluation"); ax[0, 5].set_ylabel("|a_out|^2 (optimizer units)"); ax[0, 5].set_title("MMA history", fontsize=8); ax[0, 5].grid(alpha=0.3); ax[0, 5].legend(fontsize=7)
for k in range(5):
    show_design(ax[1, k], design_history[k], f"MMA eval {k + 1}  FOM {history[k]:.1f}" + ("  (kept)" if k == best_k else ""))
ax[1, 0].set_ylabel("y [um]")
show_design(ax[1, 5], x_optimized, f"optimized (eval {best_k + 1})\n{gray} grey px of {NX * NY}")
fig.suptitle("top: one manual gradient step (alpha sweep) and the MMA history; bottom: the design at every MMA evaluation", fontsize=10)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "06_step_mma.png"), dpi=150); plt.close(fig)


# ---------------------------------------------------------------- contract 4: fresh simulation, modal power / input mode-1 power
def modal_power(weights, res=RES):
    s = mp.Simulation(geometry=geometry_with(weights), **dict(common, resolution=res))
    mon = s.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(0, MON_OUT_Y), size=mp.Vector3(2, 0)))
    dft = s.add_dft_fields([mp.Ez], fcen, 0, 1, center=mp.Vector3(), size=mp.Vector3(SX, SY))
    s.run(until_after_sources=stop_cond)
    total = float(mp.get_fluxes(mon)[0])
    mode1 = float(abs(s.get_eigenmode_coefficients(mon, [1], direction=mp.Y).alpha[0, 0, 0]) ** 2)
    field = s.get_dft_array(dft, mp.Ez, 0); eps = s.get_epsilon(); s.reset_meep()
    return mode1, total, field, eps


report = {}
for tag, weights in (("start", x_start), ("optimized", x_optimized)):
    mode1, total, fld, eps = modal_power(weights)
    report[tag] = {"mode1": mode1, "total": total, "T_mode1": mode1 / input_power, "T_total": total / input_power, "field": fld, "eps": eps}
    print(f"verify [{tag}]: mode-1 power {mode1:.4e}, total flux {total:.4e} -> T_mode1 {mode1 / input_power:.4f}, T_total {total / input_power:.4f}")
# resolution check of the final design (same 11 x 11 densities, finer Yee grid)
res_check = {}
for res in (RES, 2 * RES):
    m1, tot, _, _ = modal_power(x_optimized, res=res)
    s_in2 = mp.Simulation(geometry=straight, **dict(common, resolution=res))
    mi = s_in2.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(MON_IN_X, 0), size=mp.Vector3(0, 2)))
    s_in2.run(until_after_sources=mp.stop_when_fields_decayed(30, mp.Ez, mp.Vector3(MON_IN_X, 0), 1e-5))
    pin = float(abs(s_in2.get_eigenmode_coefficients(mi, [1], direction=mp.X).alpha[0, 0, 0]) ** 2); s_in2.reset_meep()
    res_check[res] = {"T_mode1": m1 / pin, "T_total": tot / pin}
    print(f"resolution check [{res}]: T_mode1 {m1 / pin:.4f}, T_total {tot / pin:.4f}")

fig, ax = plt.subplots(1, 3, figsize=(13, 4.2), gridspec_kw={"width_ratios": [1.1, 1, 1]})
idx = np.arange(2)
tm = [report["start"]["T_mode1"], report["optimized"]["T_mode1"]]; tt = [report["start"]["T_total"], report["optimized"]["T_total"]]
ax[0].bar(idx - 0.2, tm, width=0.4, color="tab:blue", label="T_mode1 (output mode 1)"); ax[0].bar(idx + 0.2, tt, width=0.4, color="tab:gray", label="T_total (all flux)")
for k in range(2):
    ax[0].text(k - 0.2, tm[k] + 0.01, f"{tm[k]:.4f}", ha="center", fontsize=8); ax[0].text(k + 0.2, tt[k] + 0.01, f"{tt[k]:.4f}", ha="center", fontsize=8)
ax[0].set_xticks(idx); ax[0].set_xticklabels(["uniform start", f"after MMA (eval {best_k + 1})"]); ax[0].set_ylim(0, 1.0); ax[0].set_ylabel("normalized to input mode-1 power")
ax[0].set_title("contract 4: measured again in a new simulation", fontsize=9); ax[0].grid(axis="y", alpha=0.3); ax[0].legend(fontsize=7)
lim = max(np.max(np.abs(report["start"]["field"])), np.max(np.abs(report["optimized"]["field"])))
for a, tag in zip(ax[1:], ("start", "optimized")):
    a.imshow(np.real(report[tag]["field"]).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-lim, vmax=lim, aspect="equal")
    contour(a, report[tag]["eps"]); a.set_title(f"Re(Ez), {tag}  (T_mode1 = {report[tag]['T_mode1']:.3f})", fontsize=9); a.set_xlabel("x [um]")
ax[1].set_ylabel("y [um]")
fig.tight_layout(); fig.savefig(os.path.join(OUT, "07_verify.png"), dpi=150); plt.close(fig)

# ---------------------------------------------------------------- GIF 1: a short pulse through the optimized bend (source -> output monitor)
fw_anim = 0.3 * fcen
sim_a = mp.Simulation(geometry=geometry_with(x_optimized), **dict(common, sources=[
    mp.EigenModeSource(mp.GaussianSource(fcen, fwidth=fw_anim), eig_band=1, direction=mp.NO_DIRECTION, eig_kpoint=mp.Vector3(1, 0, 0),
                       size=mp.Vector3(0, SRC_SIZE), center=mp.Vector3(SRC_X, 0))]))
sim_a.init_sim()
vol_a = mp.Volume(center=mp.Vector3(), size=mp.Vector3(SX - 2 * DPML, SY - 2 * DPML))
eps_a = sim_a.get_array(vol=vol_a, component=mp.Dielectric)
ext_a = [-(SX / 2 - DPML), SX / 2 - DPML, -(SY / 2 - DPML), SY / 2 - DPML]
t0 = 5 / fw_anim
path = abs(SRC_X) + SY / 2                                    # input straight + output straight, roughly
frames, times = record_frames(sim_a, vol_a, mp.Ez, t_start=t0 - 2 / fw_anim, t_end=t0 + 1.2 * path * 3.4, n_frames=60)
animate_fields(frames, times, ext_a, os.path.join(OUT, "08_anim_optimized.gif"), eps=eps_a, figsize=(6.2, 5.0), dpi=70,
               lines=[((SRC_X, -1), (SRC_X, 1), "red", "source"), ((-1, MON_OUT_Y), (1, MON_OUT_Y), "blue", "output monitor")],
               title="optimized bend", legend_loc="lower right")

# ---------------------------------------------------------------- GIF 2: how the design changed, start -> every MMA eval -> final
evo = [x_start] + design_history + [x_optimized]
evo_lab = ["start"] + [f"eval {k + 1}" for k in range(len(design_history))] + [f"final (eval {best_k + 1})"]
evo_fom = [f_start] + history + [max(history)]
fig_e, ax_e = plt.subplots(figsize=(4.0, 3.8))
im_e = ax_e.imshow(evo[0].reshape(NX, NY).T, origin="lower", extent=DEXT, cmap="gray_r", vmin=0, vmax=1, aspect="equal")
ax_e.set_xlabel("x [um]"); ax_e.set_ylabel("y [um]"); ttl_e = ax_e.set_title("", fontsize=9)
fig_e.colorbar(im_e, ax=ax_e, fraction=0.046, label="density (0 = SiO2, 1 = Si)")
fig_e.tight_layout()


def _evo(i):
    im_e.set_data(evo[i].reshape(NX, NY).T); ttl_e.set_text(f"{evo_lab[i]}   FOM = {evo_fom[i]:.1f}")
    return im_e, ttl_e


animation.FuncAnimation(fig_e, _evo, frames=len(evo), blit=False).save(os.path.join(OUT, "09_anim_design.gif"), writer=animation.PillowWriter(fps=1.5), dpi=80)
plt.close(fig_e)

if mp.am_master():
    with open(os.path.join(OUT, "result.json"), "w") as f:
        json.dump({"params": {"wl": wl, "res": RES, "cell": [SX, SY], "w": W, "design": [D, D], "N": [NX, NY], "fwidth_rel": 0.12},
                   "source_check": {"total_in": total_in, "input_power": input_power, "mode1_share": input_power / total_in},
                   "fom": {"start": f_start, "random": f_random, "grad_norm": float(np.linalg.norm(g_start)),
                           "grad_max": float(g2.max()), "grad_min": float(g2.min()), "grad_pos": int((g2 > 0).sum()), "grad_neg": int((g2 < 0).sum())},
                   "gate": gate_rows, "gate_pass": gradient_gate,
                   "one_step": [{"alpha": a, "fom": f} for a, _, f in one_step],
                   "mma": {"history": history, "best_eval": best_k + 1, "gray_pixels": gray},
                   "verify": {k: {kk: vv for kk, vv in v.items() if kk not in ("field", "eps")} for k, v in report.items()},
                   "resolution_check": res_check,
                   "x_optimized": x_optimized.tolist(),
                   "wall_s_total": time.time() - t_all, "meep": mp.__version__, "nlopt": f"{nlopt.version_major()}.{nlopt.version_minor()}"}, f, indent=2)
§4의 발췌 코드와 달리 전체 코드에는 그림 저장·GIF 두 개·result.json 기록·해상도 20 재측정이 들어 있다. 그림 helper blogfig.py는 시리즈 공통이며 같은 폴더(code/)에 있다. 전체 코드와 helper: https://github.com/jin-castle/meep-examples/blob/main/code.
실행 결과 (2026-10-23 실행):
source check: input flux 2.09705e+02, mode-1 power 2.10614e+02, mode-1 share 1.0043
forward: uniform-0.5 FOM = 4.3095 (|grad| = 3.824e+01); random start FOM = 12.2263; adjoint sources: 1 x EigenModeSource
gradient: max +4.4568e+00, min -1.3404e+01; positive pixels 49, negative 72
gate: step 2e-03: FD 3.82396e+01 vs adjoint 3.82395e+01, rel 0.0000 PASS; step 5e-03: FD 3.82405e+01 vs adjoint 3.82395e+01, rel 0.0000 PASS; step 1e-02: FD 3.82436e+01 vs adjoint 3.82395e+01, rel 0.0001 PASS -> gradient gate PASS
one manual step: alpha 0.2 -> 16.657 (3.9x), alpha 1.0 -> 118.917 (27.6x), alpha 3.0 -> 176.244 (40.9x), alpha 8.0 -> 235.537 (54.7x)
MMA (maxeval 5): eval 1: 4.310, eval 2: 180.684, eval 3: 4.533, eval 4: 106.244, eval 5: 222.402; best eval 5 = 222.402 (51.6x); grayscale pixels 119/121
verify [start]: mode-1 power 3.2469e+00, total flux 2.4546e+01 -> T_mode1 0.0154, T_total 0.1165
verify [optimized]: mode-1 power 1.6429e+02, total flux 1.6933e+02 -> T_mode1 0.7801, T_total 0.8040
resolution check [10]: T_mode1 0.7801, T_total 0.8040
resolution check [20]: T_mode1 0.6391, T_total 0.6870
재현 환경: meep 1.33.0 · nlopt 2.x · autograd · Python 3.11 · conda install -c conda-forge pymeep nlopt autograd · 실행 python bend_inverse.py (약 29 s, 단일 코어)
공식 문서와 이어 읽기
- 공식 Adjoint Solver 튜토리얼 · adjoint 예제 01 Introduction (waveguide bend) · adjoint 예제 02 filtering and projection
MaterialGrid레퍼런스 ·EigenModeSource· NLopt MMA- 이전 글: 08 · Metagrating inverse design · 설계 변수 하나였던 bend: 05 · Bent waveguide와 radius trade-off · 시리즈 처음: 01 · Point source와 line source · 다음 글(시즌 2): 10 · 점광원의 3D 방사 패턴