MEEP EXAMPLES 08
격자의 빛을 원하는 방향으로 더 보내려면?
73개 밀도를 바꿔 +1차 효율을 높입니다. 실제 gradient를 검증하고 한 번의 갱신과 별도 측정을 연결합니다.
이 글을 읽고 나면
- forward·adjoint에서 밀도 gradient를 얻는 흐름을 설명한다.
- 유한차분 gate와 한 번의 step으로 미분의 의미를 확인한다.
- optimizer 점수와 새 시뮬레이션의 차수별 효율을 구별한다.
먼저 알면 좋은 것 06편 회절 차수 · 07편 meta-atom library와 supercell
1. 먼저 보기: 같은 격자로 더 많은 빛을 보낼 수 있을까?
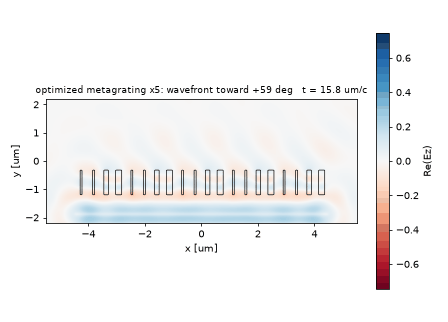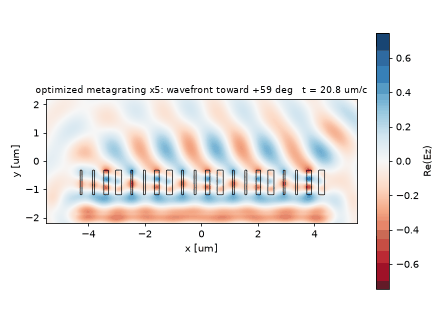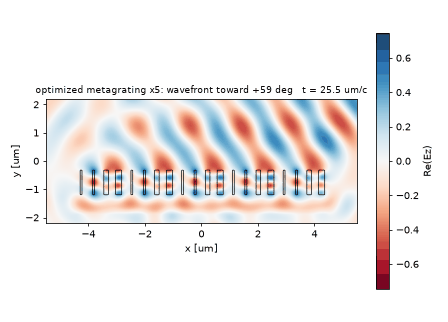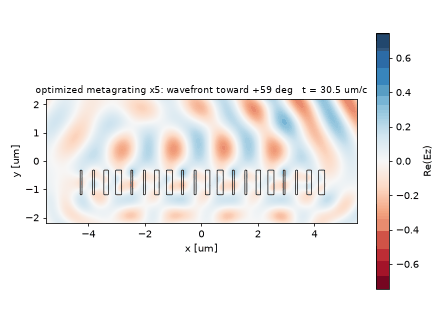
07편에서 고른 네 개의 Si 막대는 서로 다른 이웃과 만나면 library에서 예상한 응답과 달라집니다. 이번에는 한 주기 전체를 73개 밀도 변수로 열어, 오른쪽 위 +1차로 나가는 빛을 늘려 봅니다.
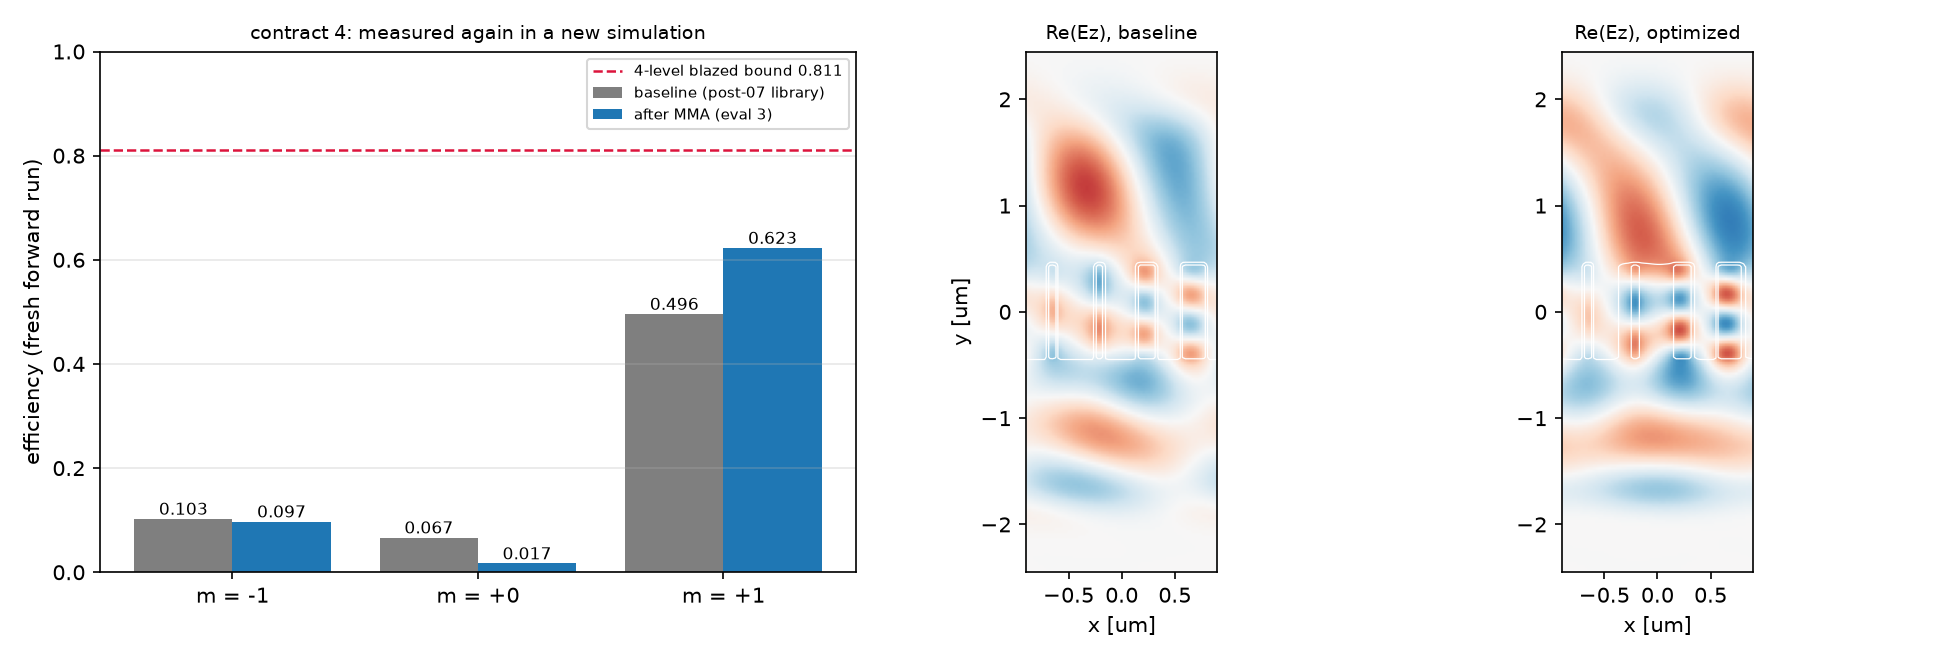
개선과 수렴은 다릅니다. 이 결과는 MMA 5회 평가 중 가장 좋았던 3회차입니다. 73개 중 27개가 회색조이며, 최소 선폭·이진화 제약과 해상도 수렴 검증이 없어 제작 가능한 최적 설계로 볼 수 없습니다.
2. 먼저 예측하기: gradient 방향이면 멀리 갈수록 좋을까?
예측과 실제 결과 비교하기
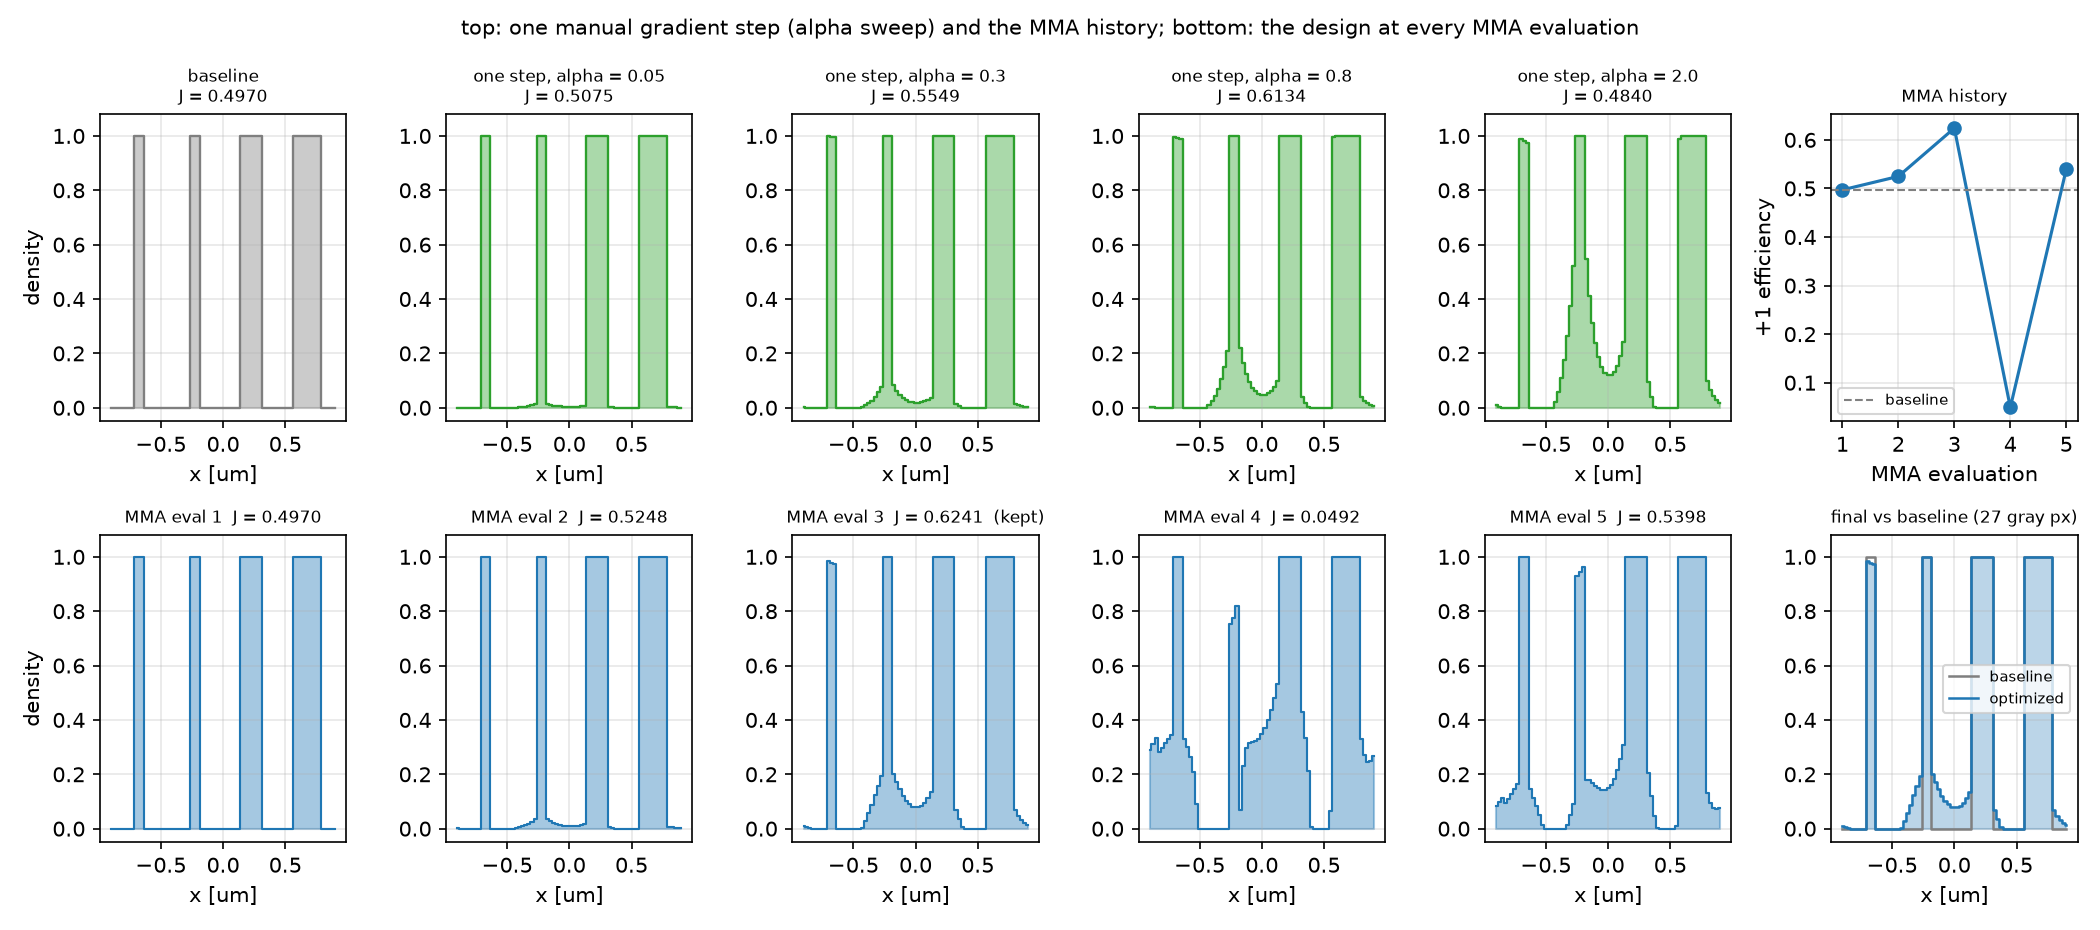
두 번째입니다. 원래 실행에서는 α = 0.8일 때 J = 0.6134까지 올랐지만, α = 2.0에서는 0.4840으로 출발점 0.4970보다 낮아졌습니다. gradient는 현재 설계 주변의 기울기이고 먼 설계의 성능을 보장하지 않습니다.
3. 원리 이해하기: 기울기를 검증한 뒤 재료를 바꾸기
밀도 ρ = 0은 공기, 1은 Si이며 사이는 유전율을 보간한 값입니다. 73개 변수는 가로 x 방향의 세로 띠를 바꿉니다. 한 띠의 높이 0.9 µm 전체는 같은 밀도를 사용하고 SiO₂ 기판은 고정합니다.
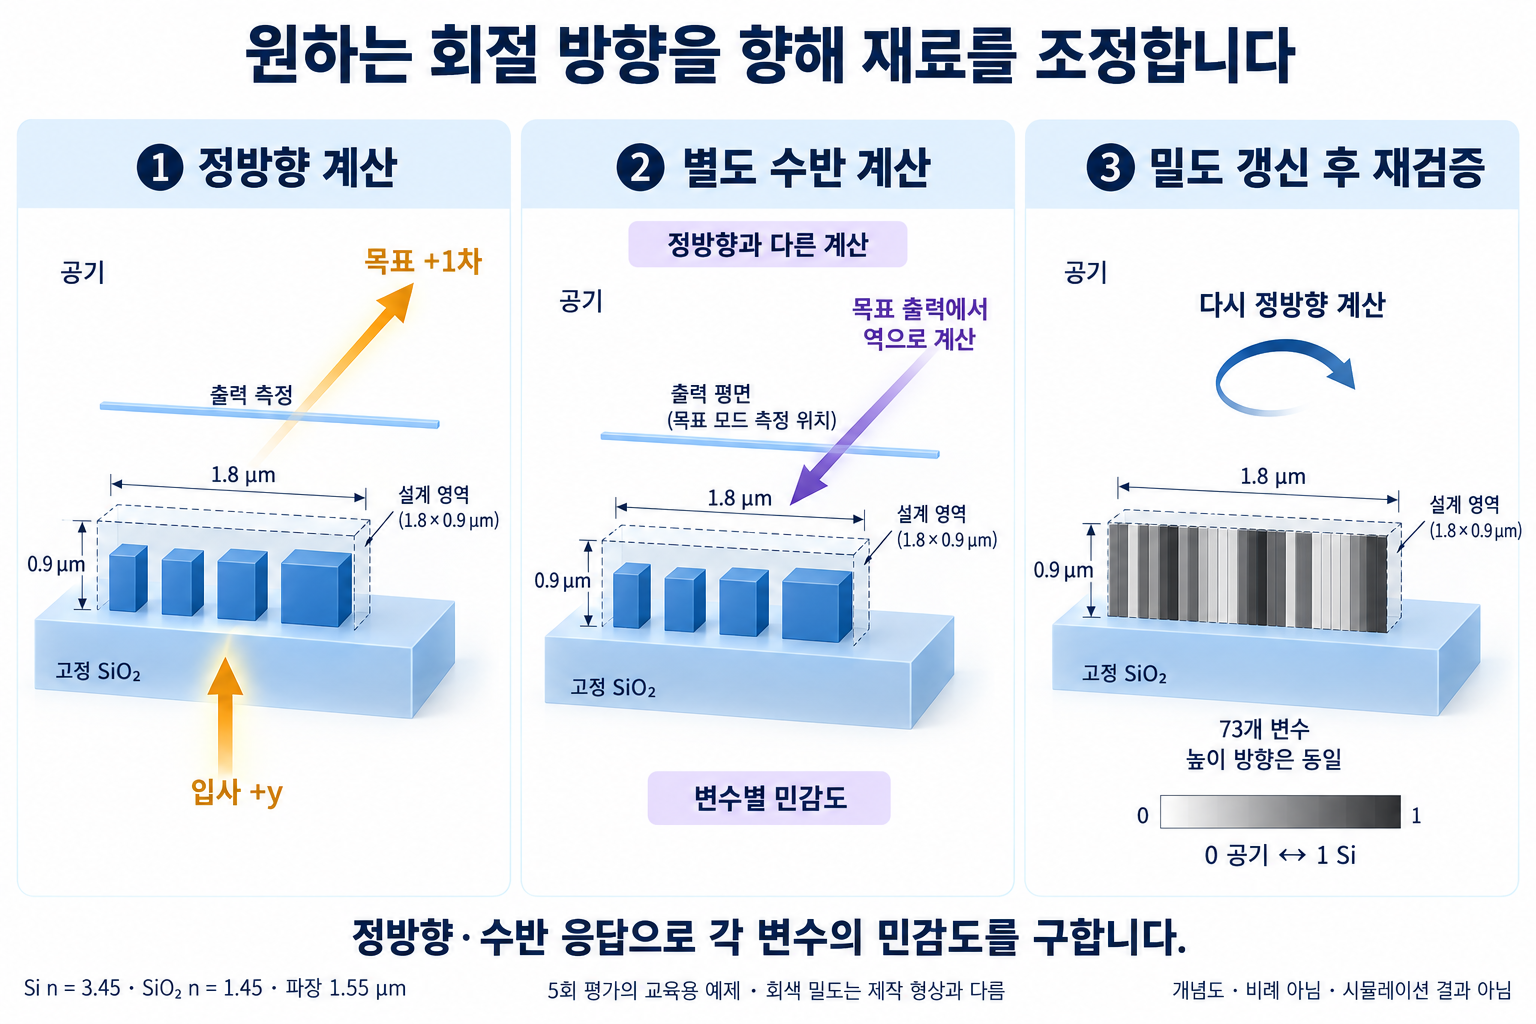
- Forward: 원래 광원으로 빛을 보내 +1차 모드 진폭을 구합니다.
- Adjoint: 목적함수에서 유도한 source를 출력 monitor에 놓고 별도 계산합니다.
- Gradient gate: 저장한 두 field와 재료의 밀도 의존성으로 구한 미분을 유한차분과 비교합니다.
- 갱신과 재측정: 먼저 손으로 한 걸음, 이어서 MMA로 갱신하고 새 시뮬레이션으로 차수별 power를 다시 잽니다.
목적함수는 J = |a₊₁|²/P_in입니다. 이 단일 주파수·단일 목적함수 예제에서는 forward와 adjoint 두 계산으로 모든 밀도의 미분을 얻습니다. 하지만 두 field의 밝기를 그냥 곱한 그림이 곧 최종 형상은 아닙니다.
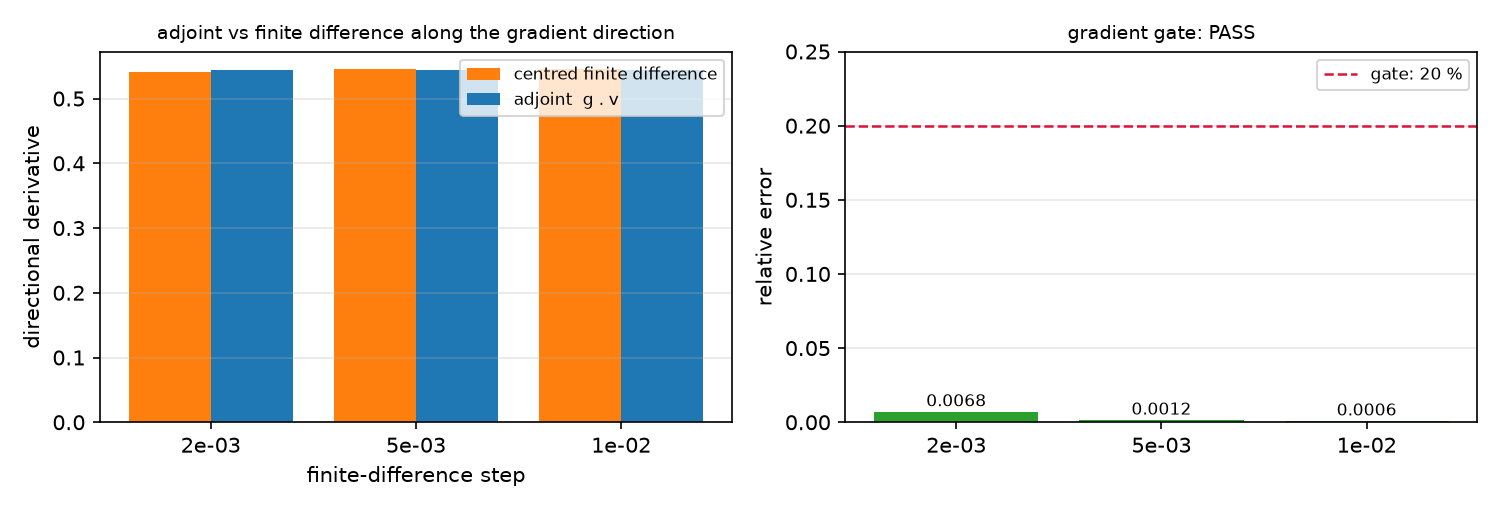
gate에서는 0/1 경계에서 떨어진 내부점과 gradient 방향을 사용합니다. 중심차분이 clipping으로 잘리지 않아야 같은 미분을 비교할 수 있습니다. 세 step의 상대오차는 0.68%, 0.12%, 0.06%로 기준 20%를 통과했습니다. 이는 이 설정에서의 미분 검증이며, 최적화나 해상도 수렴의 증명은 아닙니다.
모델 범위. 2D Ez, 파장 1.55 µm, x 주기경계·y PML, 해상도 40입니다. 설계 영역은 73 × 1이고 경계 평균·필터·투영을 사용하지 않습니다. 필터나 투영을 추가하면 그 mapping의 미분도 연결해야 합니다.
4. 직접 실행하기: 한 번의 step 크기만 바꾸기
Meep 1.33.0, nlopt, autograd가 준비된 환경에서 저장소의 code/ 폴더를 사용합니다. 전체 코드와 공통 helper는 아래 참고 자료에서 확인할 수 있습니다. 먼저 원본 실행을 보관합니다. 원래 기록은 단일 코어 약 48초입니다.
OMP_NUM_THREADS=1 python metagrating_inverse.py
이번 실험은 α = 2.0을 1.2로 바꾸는 것 하나입니다. 손 step을 순회하는 for alpha in (0.05, 0.3, 0.8, 2.0):에서 마지막 값만 1.2로 바꾸고 같은 명령으로 실행하세요. gradient·출발점·MMA 평가 수는 그대로 둡니다.
실행 로그의 one manual step에서 α = 0.8, 1.2의 J와 ΔJ를 비교하세요. α = 1.2는 0.8보다 멀리 움직이지만 더 좋아진다는 보장은 없습니다. 새 결과는 직접 측정해야 하며, 기존 α = 2.0의 0.4840을 새 결과로 사용하지 않습니다.
5. 결과 해석하기: 오른 것은 어떤 차수인가?
| 새 시뮬레이션의 측정값 | 원래 설계 | 갱신 설계 |
|---|---|---|
| 목표 +1차 효율 | 0.4959 | 0.6228 |
| 0차 효율 | 0.0666 | 0.0169 |
| −1차 효율 | 0.1026 | 0.0973 |
| 차수 합 = 총 투과율 | 0.6651 | 0.7369 |
개선은 주로 0차 누설을 줄이는 데서 왔습니다. −1차는 거의 그대로입니다. 차수 합과 총 flux가 같은지도 함께 확인해야 차수 분해를 신뢰할 수 있습니다.
MMA 내부의 최고 J는 0.6241, 별도 검증의 +1차 효율은 0.6228입니다. 차이는 작지만, 보고하는 효율은 새 run에서 측정한 값입니다. 중간 4회차의 J = 0.0492처럼 평가가 나빠질 수 있으므로 마지막 평가 대신 보관한 최고 설계를 검증합니다.
6. 이해 확인하기
- gradient gate가 통과했는데도 큰 α에서 효율이 떨어질 수 있는 이유는 무엇인가요?
- 최종 효율로 MMA의 0.6241과 새 run의 0.6228 중 어느 값을 보고하고, 함께 확인할 것은 무엇인가요?
두 질문의 답 확인하기
- gate는 현재 내부점의 국소 미분을 검증합니다. 큰 이동에서는 선형 근사가 깨지고 밀도가 0/1로 clip될 수도 있어 성능 증가를 보장하지 않습니다.
- 새 run의 0.6228을 보고합니다. 차수 합과 총 flux의 일치, 최고 설계의 선택, 회색조와 해상도·제작 제약의 한계를 함께 확인합니다.
7. 참고 자료와 전체 코드
아래에는 원본의 자세한 설명·측정 표·실행 기록을 남겼습니다. 위의 한 가지 실험을 마친 뒤 필요한 항목을 펼쳐 보세요.
English summary
TL;DR (English)
- What: the post-07 library design (four Si bars) becomes the starting point of an adjoint optimisation. The whole supercell period is a 1D design region of 73 density pixels; the objective is the +1-order efficiency. Four steps are enforced: differentiable materials, a finite-difference gate on the gradient, a short MMA run, and a fresh-simulation verification.
- Result: the gradient passes the gate (0.7 %, 0.1 %, 0.06 % error at three step sizes). One hand-made gradient step lifts the efficiency from 0.497 to 0.613; five MMA evaluations reach 0.624. Measured again in a new simulation, order by order: +1 goes from 0.496 to 0.623 (61 % → 77 % of the 4-level bound), 0 drops from 0.067 to 0.017, −1 stays near 0.10.
- Takeaway: adjoint gives you every pixel’s derivative for the price of two runs, but a wrong gradient fails silently. Gate it, take one step by hand before trusting an optimiser, and never report the optimiser’s own number: re-measure in a clean run. maxeval = 5 is a smoke test, not a converged design, and 27 of 73 pixels are still grey.
- Code: full script at the bottom, ~48 s on one core.
배경·물리식·파라미터 자세히 보기
원본 §0 · 이 글에서 배우는 것
meep.adjoint의 세 요소:MaterialGrid설계 변수,DesignRegion,EigenmodeCoefficient목적함수를 묶는OptimizationProblem- forward field와 adjoint field가 각각 무엇이고 gradient가 왜 둘의 곱인지
- gradient gate: gradient 방향의 중심차분과 g·v를 비교하는 법, 그리고 랜덤 방향·경계점을 쓰면 왜 틀리는지
- optimizer 전에 손으로 한 걸음 가 보기. step size가 커지면 선형 근사가 깨진다
- MMA 5회의 의미와 한계. 회색조 픽셀은 재료가 아니다
- 계약 4: optimizer 내부 FOM이 아니라 새 시뮬레이션의 차수별 power로 다시 재기
전제 지식: 07편의 library와 supercell, 06편의 DiffractedPlanewave. 공식 문서: Adjoint Solver 튜토리얼, adjoint 예제 01. 이전 글: 07 · Metalens의 meta-atom과 phase library · 다음 글: 09 · Waveguide bend inverse design
원본 §1 · 무엇을 알고 싶은가
07편의 4단계 설계는 +1차에 51%를 보냈고 상한 0.81의 63%였다. 모자란 이유는 library가 “이웃이 나와 같다”는 가정에서 나온 값이라는 것이었다. 그 가정을 버리고 73개 픽셀의 밀도를 전부 설계 변수로 열면 얼마나 회복되는가. 이것이 이 글의 질문이고, 답보다 중요한 것은 답을 믿어도 되는지 확인하는 절차다. adjoint 최적화는 gradient가 틀려도 에러 없이 조용히 엉뚱한 곳으로 수렴한다.
어디에 쓰이는가
metagrating은 LiDAR의 빔 조향과 대각도 회절 소자의 핵심이고, adjoint 역설계는 그 성능을 library 설계 너머로 올리는 표준 방법이다.
| 응용 | 이 글의 어떤 것을 쓰는가 | 그 다음에 필요한 것 |
|---|---|---|
| LiDAR·빔 조향, 대각도 회절 | +1차 효율 최대화, 이웃을 고려한 비국소 설계 | — |
| 모든 topology optimization 입문 | adjoint 4단계 계약 | 09편, 32~36편 |
| 메타표면 제조 전 검증 | fresh-run 검증, 회색조 문제 | 32편 filter·projection |
원본 §2 · 물리 한 페이지
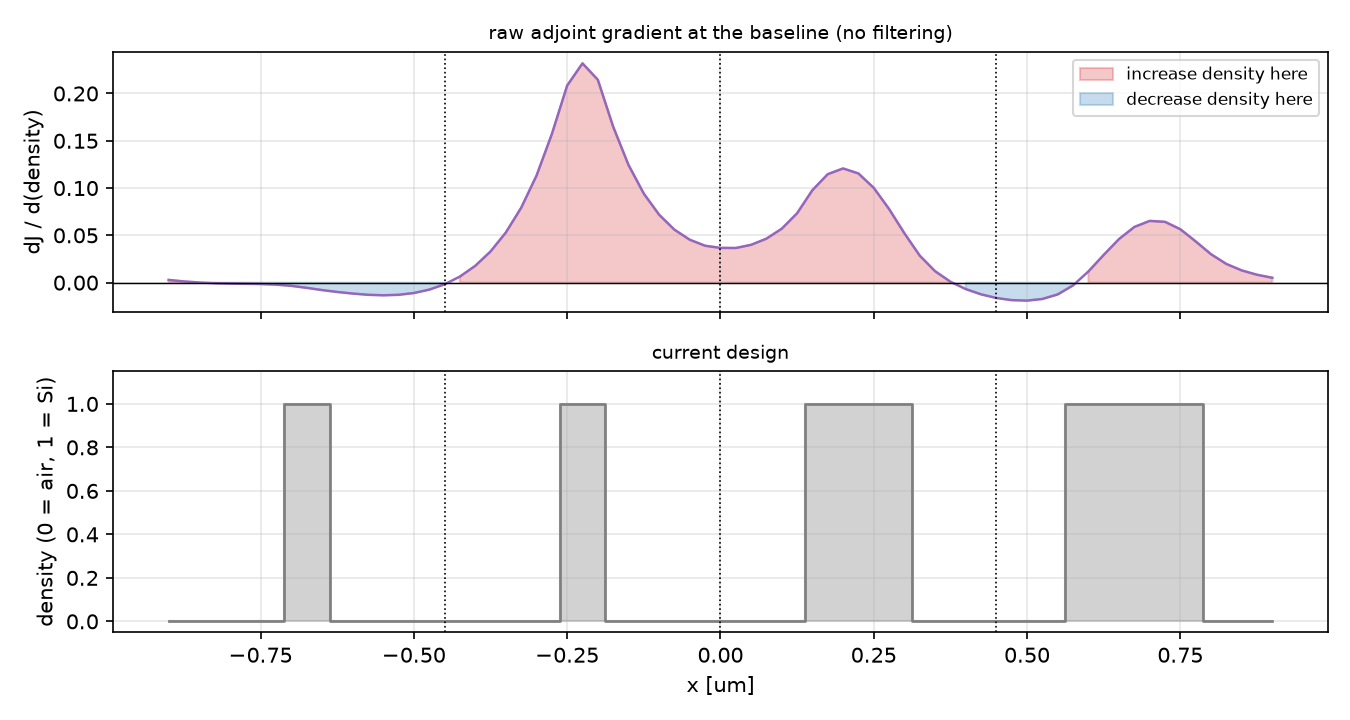
목적함수 J = |a₊₁|²/P_in은 73개 밀도 ρ의 함수다. 미분 ∂J/∂ρ_i를 하나씩 유한차분으로 구하면 146번의 시뮬레이션이 필요하다. adjoint 방법은 두 번으로 끝낸다. 원래 source로 쏜 forward field E_f와, 목적함수 monitor 자리에서 거꾸로 쏜 adjoint field E_a의 곱이 모든 픽셀의 gradient다. “빛이 실제로 지나는 곳”과 “목적함수가 민감한 곳”이 겹치는 픽셀에서 gradient가 크다.
\[\frac{\partial J}{\partial \rho_i}\;\propto\;\mathrm{Re}\big(E_f\cdot E_a\big)\Big\lvert _{\text{pixel } i},\qquad \text{gate: }\;\frac{\lvert \,g\cdot v - \mathrm{FD}_v\,\lvert }{\lvert \mathrm{FD}_v\lvert }\le 0.2,\quad v=\frac{g}{\lvert g\lvert },\quad \mathrm{FD}_v=\frac{J(x+sv)-J(x-sv)}{2s}\]gate에서 두 가지를 지킨다. 방향 v는 gradient 방향이다. 설계 변수가 N개일 때 랜덤 방향과 gradient의 내적은 1/√N 크기라 방향미분이 작아지고 몇 %의 절대오차가 수십 %의 상대오차로 부풀려진다. 그리고 경계(ρ = 0, 1)에서 떨어진 내부점에서 잰다. 0/1 설계에서 x ± sv는 항목마다 한쪽이 clip되어 중심차분이 한쪽 미분만 세고, adjoint의 정확히 절반이 나온다. adjoint 오류가 아니라 FD의 결함이다.
| 기호 | 뜻 | 코드 변수 |
|---|---|---|
| ρ (73개) | 설계 밀도. 0 공기, 1 Si, 사이는 회색조 | x_baseline, x_optimized |
| J | +1차 효율 = |a₊₁|²/P_in | fom(x) |
| g | adjoint gradient ∂J/∂ρ | g_baseline |
| v, s | gate 방향(g/|g|), FD step | v, steps |
| α | 손 step 크기 | one_step |
| k_diff | +1차 평면파 방향 (1/Λ, √(f² − 1/Λ²)) | kdiff |
가정과 유효 범위: 2D Ez, 1D 설계 영역(높이 방향 1픽셀, 막대 높이 전체가 한 변수), 단일 주파수, eps_averaging=False로 경계 평균 없음. 제작 제약(최소 선폭, 이진화)은 없다.
결과 보기 전에 맞춰보기
| 물리량 | 내 예측 | 근거 |
|---|---|---|
| gate 상대오차 | 1% 안 | 10_sources의 adjoint 튜토리얼 재현에서 2 × 10⁻⁶ |
| gradient가 큰 곳 | 막대 가장자리 | 경계를 옮기는 것이 가장 효과가 크다 |
| 손 step | α를 키우면 오르다가 꺾임 | 선형 근사의 한계 |
| MMA 5회 | 0.497에서 0.6 근처로, 중간에 추락 가능 | MMA가 신뢰영역을 넓게 잡았다 되돌림 |
| 별도 검증 vs optimizer FOM | 소수 둘째 자리에서 다름 | 설계 격자(MaterialGrid 73 px)와 분해 monitor가 같아 비슷하지만 종료 조건이 다르다 |
| 회색조 픽셀 | 수십 개 | 이진화 없이 5회 |
판정 기준: gate 상대오차 > 20%면 HOLD. 그 뒤는 해석하지 않는다. 차수 합 ≠ 총 flux면 분해 오류.
원본 §3 · 시뮬레이션 설계도
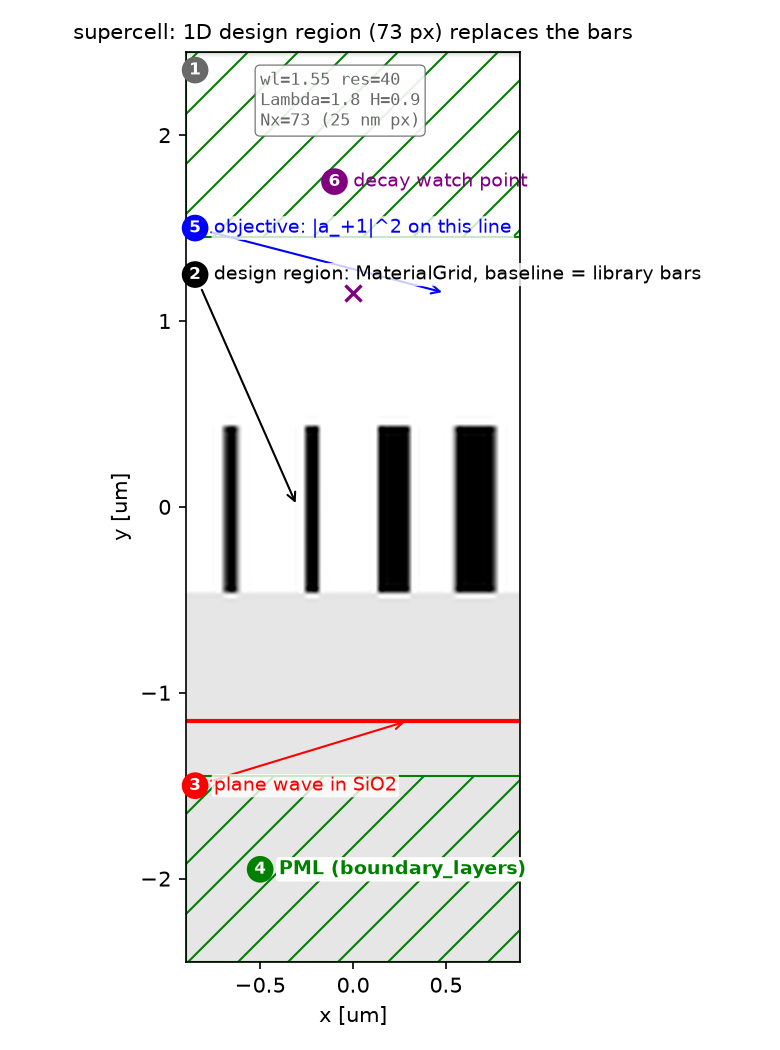
MaterialGrid 설계 영역(폭 1.8 µm, 높이 0.9 µm, 73 픽셀)으로 바뀌었고 초기값은 library의 네 막대다. 빨간 가로선 = 기판 안 평면파, 파란 가로선 = 목적함수 monitor(+1차 진폭), 녹색 빗금 = y PML, x는 주기 경계. 동그라미 숫자는 §4의 단계 번호다.| 파라미터 | 값 | 왜 이 값인가 | 바꾸면 |
|---|---|---|---|
| 셀·주기·높이·해상도 | 07편과 동일 (1.8 × 4.9 µm, res 40) | library를 그대로 초기값으로 쓰려면 모두 같아야 한다 | 하나라도 다르면 baseline이 07편 설계가 아니다 |
Nx |
73 (25 nm 픽셀) | 셀 폭 × res + 1 | 늘리면 변수는 늘지만 격자보다 가늘어져 의미 없다 |
decay_by |
1e-6 | adjoint run의 종료 기준. 느슨하면 adjoint만 무너진다(10_sources fdcheck) | 1e-4면 adjoint gradient가 81% 틀어진다 |
| gate steps | 2e-3, 5e-3, 1e-2 | 절단오차와 반올림오차 사이 | 1e-6이면 반올림 반등 |
maxeval |
5 | 수업용 smoke test | 수렴을 보려면 수십 회 + 이진화 |
| 손 step α | 0.05, 0.3, 0.8, 2.0 | 꺾이는 지점(0.8 근처) 포함 | — |
강의 노트북과의 차이: 없다. 4단계 계약, 파라미터, 수치(gate 0.0068/0.0012/0.0006, MMA 0.497 → 0.624, 검증 0.496 → 0.623) 모두 강의 week 9와 같다. 이 글은 10_sources의 두 fdcheck 노트에서 얻은 “gate가 깨지는 네 가지 이유”를 §6에 더했다.
원본 코드 단계별 설명
원본 §4 · 코드 따라가기
읽는 순서: 단위·파라미터 → 재료·구조 → source → Simulation·경계 → monitor → 실행·종료 → 후처리. 이번 글의 ⑤는 “목적함수”이고 ⑥·⑦은 forward·adjoint·gate·MMA·검증으로 늘어난다.
① 단위와 파라미터 — 어떤 숫자를 고정하는가
wl, fcen, fwidth = 1.55, 1 / 1.55, 0.1 / 1.55
N_SEC, LA = 4, 0.45; LAMBDA = N_SEC * LA; H = 0.9; RES = 40
W_LIB = np.array([0.075, 0.100, 0.175, 0.225])          # post-07 design (read from assets/07/result.json)
Nx, Ny = int(round(RES * LAMBDA)) + 1, 1                  # 73 x 1 design pixels
x_grid = np.linspace(-0.5 * LAMBDA, 0.5 * LAMBDA, Nx)
x_baseline = np.zeros(Nx)
for j, w in enumerate(W_LIB):
    xj = -0.5 * LAMBDA + (j + 0.5) * LA
    x_baseline[np.abs(x_grid - xj) <= 0.5 * w] = 1.0    # the four bars, as 0/1 densities
- 무엇: 07편 파라미터를 그대로 두고, library 설계를 73개 0/1 밀도로 옮긴다.
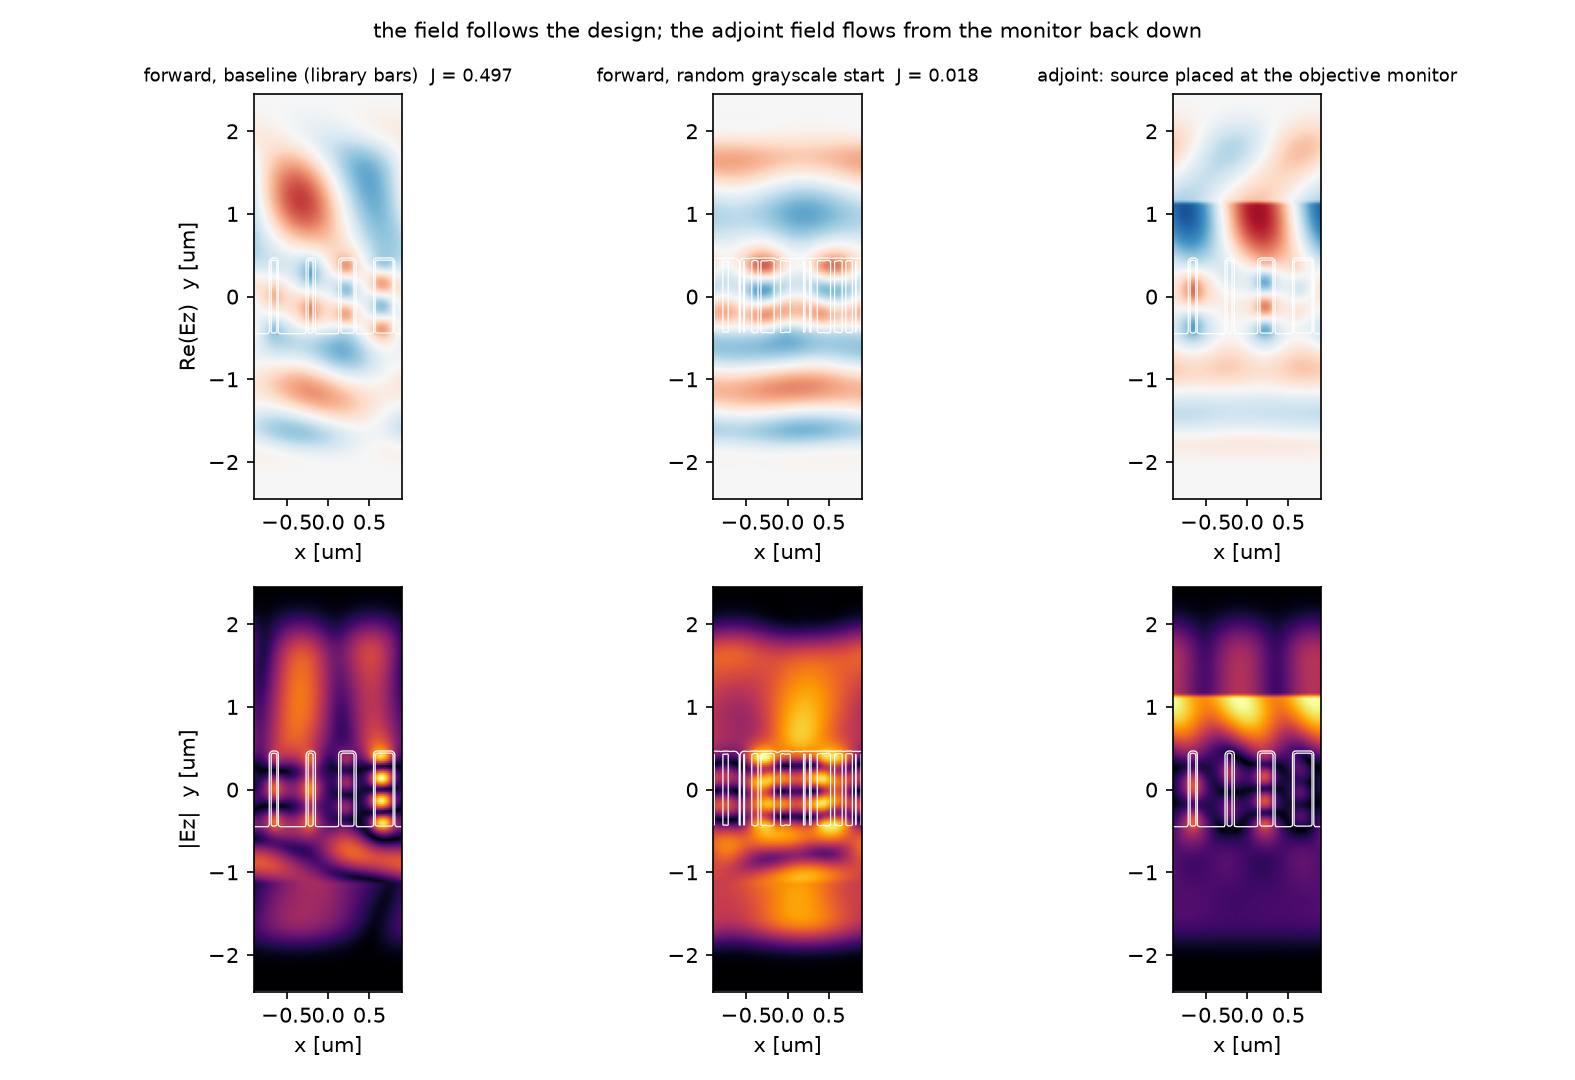
- 왜: 출발점이 랜덤이 아니라 “이미 괜찮은 설계”여야 “adjoint가 간극을 얼마나 메우는가”를 물을 수 있다. 랜덤 회색조는 +1차 효율 0.018에서 시작한다(§5).
- 틀리면: 픽셀 폭 25 nm와 library 폭(0.075 = 3 px)이 맞지 않으면 baseline이 07편과 다른 구조가 된다.
② 재료와 구조 — 무엇이 어디에 있는가
design_variables = mp.MaterialGrid(mp.Vector3(Nx, Ny), mp.air, Si, grid_type="U_MEAN", do_averaging=False)   # contract 1
design_region = mpa.DesignRegion(design_variables,
                                 volume=mp.Volume(center=mp.Vector3(0, Y_DEV + 0.5 * H), size=mp.Vector3(LAMBDA, H)))
geometry = [mp.Block(..., material=SiO2),                                   # substrate
            mp.Block(center=design_region.center, size=design_region.size, material=design_variables)]
sim = mp.Simulation(geometry=geometry, eps_averaging=False, **common)
- 무엇: 막대 대신 밀도 격자.
MaterialGrid는 ρ = 0이면 공기, 1이면 Si, 사이는 선형 보간된 유전율이다. - 왜: 미분하려면 유전율이 ρ의 매끄러운 함수여야 한다.
do_averaging=False와eps_averaging=False가 계약 1이다. - 틀리면:
eps_averaging을 기본값(True)으로 두면 Meep이 경계에서 유전율을 평균해 gradient와 실제 구조가 어긋난다.
③ Source — 빛을 어떻게 넣는가
sources = [mp.Source(mp.GaussianSource(fcen, fwidth=fwidth), component=mp.Ez, center=mp.Vector3(0, SRC_Y), size=mp.Vector3(LAMBDA, 0))]
adjoint_sources = opt.adjoint_sources[0]      # what opt actually fired for the adjoint run (an EigenModeSource at the monitor)
- 무엇: forward는 07편과 같은 평면파. adjoint source는
OptimizationProblem이 목적함수 monitor 자리에 스스로 만든다. - 왜: adjoint source의 진폭과 모양은 목적함수의 미분값으로 정해진다. 우리가 고르는 게 아니라
opt가 계산한 것을 꺼내 볼 뿐이다. - 틀리면: 빈 기판 run에서 monitor 높이의 위상이 x를 따라 변하면 source가 기울어진 것이고 “+1차 효율”이라는 말이 성립하지 않는다.
④ Simulation과 경계 — 계산 상자와 PML
common = dict(resolution=RES, cell_size=mp.Vector3(LAMBDA, SY), sources=sources,
              boundary_layers=[mp.PML(thickness=DPML, direction=mp.Y)], k_point=mp.Vector3())
- 무엇: 07편 supercell과 같다. x 주기, y PML.
- 왜: 모든 run(forward, adjoint, FD, 검증)이 같은 셀을 써야 비교가 된다.
- 틀리면: 검증 run의 셀이 다르면 “optimizer FOM과 다르다”가 설계 때문인지 셀 때문인지 모른다.
⑤ Monitor — 목적함수
kdiff = mp.Vector3(1 / LAMBDA, np.sqrt(fcen ** 2 - (1 / LAMBDA) ** 2))          # +1 order direction
emc = mpa.EigenmodeCoefficient(sim, mp.Volume(center=mp.Vector3(0, MON_Y), size=mp.Vector3(LAMBDA, 0)), mode=1,
                               eig_parity=mp.ODD_Z, kpoint_func=lambda *_: kdiff,
                               eig_vol=mp.Volume(center=mp.Vector3(0, MON_Y), size=mp.Vector3(1 / RES, 0, 0)))
opt = mpa.OptimizationProblem(simulation=sim, objective_functions=lambda e: npa.abs(e[0]) ** 2,
                              objective_arguments=[emc], design_regions=[design_region], fcen=fcen, df=0, nf=1, decay_by=1e-6)
- 무엇: monitor 선 위의 +1차 평면파 진폭 a₊₁을 목적함수 인자로, |a₊₁|²를 목적함수로.
- 왜:
kpoint_func가 +1차 방향을 지정하고,eig_vol을 한 픽셀로 잡아 “평면파”임을 알린다(06편의DiffractedPlanewave에 해당).npa(autograd의 numpy)로 써야 목적함수 자체가 미분된다. - 틀리면:
eig_parity를 빼면 다른 편광 모드가 섞인다.decay_by를 1e-4로 느슨하게 하면 forward와 FD는 멀쩡한데 adjoint gradient만 81% 틀어진다(10_sources fdcheck E4).
⑥ 실행 — forward, adjoint, gate, 한 걸음, MMA
f, dJ = opt([x], need_gradient=True)            # forward + adjoint: J and dJ/drho for all 73 pixels

x_gate = np.clip(x_baseline, 0.02, 0.98)         # interior point, away from 0/1
v = g_gate / np.linalg.norm(g_gate)              # gradient direction
fd = (fom(x_gate + s * v) - fom(x_gate - s * v)) / (2 * s)
ok = abs(g_gate @ v - fd) / abs(fd) <= 0.20

x_try = np.clip(x_baseline + alpha * g / np.linalg.norm(g), 0, 1)    # one step by hand

solver = nlopt.opt(nlopt.LD_MMA, Nx); solver.set_lower_bounds(0); solver.set_upper_bounds(1)
solver.set_max_objective(nlopt_objective); solver.set_maxeval(5)
- 무엇:
opt(...)한 번이 forward와 adjoint 두 run이다. gate는 세 step으로 중심차분. 그다음 손으로 한 걸음, 그다음 MMA 5회. - 왜: 순서가 계약이다. gate를 통과하지 못한 gradient로는 아무것도 하지 않는다. 손 step은 “gradient 방향으로 가면 정말 오르는가, 얼마나 멀리까지”를 보여 준다.
- 틀리면: 0/1 baseline에서 바로 gate를 재면 clip 때문에 FD가 adjoint의 절반이 나와 HOLD가 된다. 랜덤 방향으로 재면 상대오차가 1/√73 배로 부풀려진다.
⑦ 후처리 — 계약 4, 별도 검증
def forward_orders(weights):
    s = mp.Simulation(geometry=geometry_with(weights), eps_averaging=False, **common)   # a NEW simulation
    mon = s.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(0, MON_Y), size=mp.Vector3(LAMBDA, 0)))
    s.run(until_after_sources=stop_cond)
    eff = {m: abs(s.get_eigenmode_coefficients(mon, mp.DiffractedPlanewave((m, 0, 0), mp.Vector3(1, 0, 0), 1, 0)).alpha[0, 0, 0]) ** 2 / input_flux
           for m in (-1, 0, 1)}
    return eff, mp.get_fluxes(mon)[0] / input_flux
- 무엇: 최종 설계를 새
Simulation에 넣고 06편 방식으로 세 차수를 다시 잰다. 차수 합 = 총 flux도 검산한다. - 왜: optimizer 안의 FOM은 그 optimizer의 종료 조건·monitor 설정에 묶인 숫자다. 보고할 값은 독립 run의 값이어야 한다.
- 틀리면: optimizer FOM(0.624)을 그대로 쓰면 검증값(0.623)과 미세하게 다르다. 이번엔 작지만 조건이 다르면 커진다.
함정: 여기서 설계 변수는 x에 대한 밀도 하나뿐이고 mapping(필터·투영)이 없다. mapping을 넣으면 gradient에 chain rule을 걸어야 하고, 빠뜨리면 gate의 cosine이 −0.45로 방향이 반대가 된다(10_sources fdcheck E5).
원본 결과·검증 표·오류 진단·추가 탐구
원본 §5 · 결과
| step | FD | adjoint g·v | 상대오차 |
|---|---|---|---|
| 2e-3 | 0.5410 | 0.5447 | 0.0068 |
| 5e-3 | 0.5454 | 0.5447 | 0.0012 |
| 1e-2 | 0.5451 | 0.5447 | 0.0006 |
| α | J | ΔJ |
|---|---|---|
| 0.05 | 0.5075 | +0.011 |
| 0.3 | 0.5549 | +0.058 |
| 0.8 | 0.6134 | +0.116 |
| 2.0 | 0.4840 | −0.013 |
| 설계 | m = −1 | m = 0 | m = +1 | 차수 합 | 총 투과 | +1 / 상한 |
|---|---|---|---|---|---|---|
| baseline (07편 library) | 0.1026 | 0.0666 | 0.4959 | 0.6651 | 0.6651 | 61.2% |
| optimized (MMA eval 3) | 0.0973 | 0.0169 | 0.6228 | 0.7369 | 0.7369 | 76.8% |
예측과 비교
| 물리량 | 내 예측 (§2) | 시뮬레이션 | 판정 |
|---|---|---|---|
| gate 상대오차 | 1% 안 | 0.7%, 0.1%, 0.06% | ✅ |
| gradient 큰 곳 | 막대 가장자리 | 두 번째 막대 양 끝 | ✅ |
| 손 step | 오르다 꺾임 | 0.8에서 최대, 2.0에서 하락 | ✅ |
| MMA 5회 | 0.6 근처, 중간 추락 | 0.624, 4회차 0.049 | ✅ |
| 검증 vs optimizer | 둘째 자리 차이 | 0.6228 vs 0.6241 | ✅ |
| 회색조 | 수십 개 | 27 / 73 | ✅ |
예측대로였고, 숫자로 확인된 것은 두 가지다. 07편의 “이웃이 같다” 가정이 잃던 몫의 절반 가까이를 픽셀 자유도가 되찾았다(61% → 77%). 그리고 그 개선의 대부분은 0차 누설을 줄인 데서 왔다(0.067 → 0.017). −1차는 거의 그대로다. 계단 근사의 거울상 누설은 5회로는 못 건드렸다.
수렴성
이 글의 수렴성은 해상도가 아니라 gate의 세 step이다. step을 5배 바꿔도 FD가 0.541~0.545에서 안정이고 adjoint와 1% 안에 있다. 해상도 의존성은 07편의 library 수렴성(위상 0.82 rad 변동)이 그대로 이 설계에 옮겨 온다. res 60으로 다시 돌리면 baseline 효율부터 달라진다.
주장할 수 있는 것 / 없는 것
- 할 수 있는 것: 이 셀·해상도에서 adjoint gradient는 유한차분과 1% 안에서 같다. library baseline에서 다섯 번의 MMA 평가로 +1차 효율이 0.50에서 0.62로 올랐고, 그 값은 별도 run으로 재확인됐다.
- 할 수 없는 것: “최적 설계를 찾았다”. maxeval 5는 수렴이 아니다. 73개 중 27개가 회색조라 이 패턴은 실제 소자가 아니다. 최소 선폭 제약이 없어 이진화하면 효율이 달라진다. 다른 해상도·파장·편광에서의 값.
원본 §6 · 흔한 실수
| 증상 | 원인 | 고치는 법 |
|---|---|---|
| gate에서 FD가 adjoint의 정확히 1/2 | 0/1 경계점에서 clip된 중심차분 | 내부점(0.02~0.98)에서 재기 |
| gate 상대오차 수십 % | 랜덤 방향 사용 | gradient 방향 v = g/|g| |
| gate에서 adjoint만 틀어짐 | decay_by 느슨함 |
1e-6 이하 |
| gate cosine이 음수 | mapping(필터·투영)의 chain rule 누락 | gradient에 mapping의 Jacobian 곱하기 |
| optimizer FOM과 검증값이 다름 | 조건이 다른 run | 보고는 항상 새 run의 값으로 |
| MMA가 중간에 추락 | 신뢰영역 과대 | 정상 동작. 최고 평가를 보관 |
| 회색조 설계를 소자로 해석 | 이진화·선폭 제약 없음 | 09편 이후: 필터·투영·β 스케줄 |
원본 §7 · 직접 해보기
| 바꿀 것 | 예상 변화 | 확인할 수치 |
|---|---|---|
| 초기값을 균일 0.5로 | 격자가 없어 +1차 0인 퇴화점. gradient가 어떻게 나오는지 | g, gate |
maxeval 5 → 30 |
효율이 어디서 정체하는지 | history |
| 목적함수를 |a₊₁|² − |a₋₁|²로 | −1차 누설이 줄어드는지 | 검증 표 |
gate에서 decay_by 1e-6 → 1e-4 |
adjoint만 틀어지는 것을 재현 | 상대오차 |
metagrating_inverse.py (클릭해서 펼치기)
"""Meep Example 08 - Metagrating inverse design (adjoint), with a four-step contract.

Start from the post-07 library design (four Si bars). Open the whole supercell period as a 1D design
region (73 pixels of density 0..1) and let the adjoint gradient move it. Every step is looked at:
  1. differentiability: eps_averaging=False, MaterialGrid do_averaging=False
  2. gradient gate: adjoint gradient vs centred finite differences along the gradient direction
  3. a short MMA run (maxeval 5): a smoke test, not a converged design
  4. verification in a FRESH simulation with DiffractedPlanewave, order by order
Plus: forward field of baseline and of a random start, adjoint field, raw gradient, one manual step.

Run:  python metagrating_inverse.py      (~1.5 min on one core)
Out:  00_source.png, 01_layout.png, 02_fields.png, 03_gradient.png, 04_gate.png, 05_step_mma.png,
      06_verify.png, 07_anim_optimized.gif, result.json   (-> ../assets/08/)
"""
import json
import os
import sys
import time

import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import meep as mp
import meep.adjoint as mpa
import nlopt
from autograd import numpy as npa

sys.path.insert(0, os.path.dirname(os.path.abspath(__file__)))
from blogfig import Label, animate_fields, annotated_layout, record_frames, source_figure   # noqa: E402

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, "..", "assets", "08")
os.makedirs(OUT, exist_ok=True)
t_all = time.time()
np.random.seed(20260815)

# ---------------------------------------------------------------- (1) units & parameters: identical to post 07
wl = 1.55
fcen = 1 / wl
fwidth = 0.1 * fcen
Si, SiO2 = mp.Medium(index=3.45), mp.Medium(index=1.45)
N_SEC, LA = 4, 0.45
LAMBDA = N_SEC * LA
THETA_D = float(np.degrees(np.arcsin(wl / LAMBDA)))
H = 0.9
RES = 40
DPML, DSUB, DAIR = 1.0, 1.0, 1.0
SY = DPML + DSUB + H + DAIR + DPML
Y_BOT = -0.5 * SY
Y_DEV = Y_BOT + DPML + DSUB
SRC_Y = Y_BOT + DPML + 0.3
MON_Y = -Y_BOT - DPML - 0.3
BLAZED_BOUND = (np.sin(np.pi / N_SEC) / (np.pi / N_SEC)) ** 2
EXTENT = [-0.5 * LAMBDA, 0.5 * LAMBDA, Y_BOT, -Y_BOT]

# baseline widths: post-07 library design (read from its result.json if present)
try:
    with open(os.path.join(HERE, "..", "assets", "07", "result.json")) as f:
        W_LIB = np.array(json.load(f)["design"]["widths"])
except Exception:
    W_LIB = np.array([0.075, 0.100, 0.175, 0.225])

sources = [mp.Source(mp.GaussianSource(fcen, fwidth=fwidth), component=mp.Ez, center=mp.Vector3(0, SRC_Y), size=mp.Vector3(LAMBDA, 0))]
common = dict(resolution=RES, cell_size=mp.Vector3(LAMBDA, SY), sources=sources,
              boundary_layers=[mp.PML(thickness=DPML, direction=mp.Y)], k_point=mp.Vector3())
stop_cond = mp.stop_when_fields_decayed(10, mp.Ez, mp.Vector3(0, MON_Y), 1e-7)

# ---------------------------------------------------------------- (2) geometry: substrate + a 1D MaterialGrid design region
Nx, Ny = int(round(RES * LAMBDA)) + 1, 1
x_grid = np.linspace(-0.5 * LAMBDA, 0.5 * LAMBDA, Nx)
design_variables = mp.MaterialGrid(mp.Vector3(Nx, Ny), mp.air, Si, grid_type="U_MEAN", do_averaging=False)   # contract 1
design_region = mpa.DesignRegion(design_variables, volume=mp.Volume(center=mp.Vector3(0, Y_DEV + 0.5 * H), size=mp.Vector3(LAMBDA, H)))
x_baseline = np.zeros(Nx)
for j, w in enumerate(W_LIB):
    xj = -0.5 * LAMBDA + (j + 0.5) * LA
    x_baseline[np.abs(x_grid - xj) <= 0.5 * w] = 1.0


def geometry_with(weights):
    grid = mp.MaterialGrid(mp.Vector3(Nx, Ny), mp.air, Si, weights=np.asarray(weights).reshape(Nx, Ny), grid_type="U_MEAN", do_averaging=False)
    return [mp.Block(center=mp.Vector3(0, Y_BOT + 0.5 * (DPML + DSUB)), size=mp.Vector3(mp.inf, DPML + DSUB), material=SiO2),
            mp.Block(center=design_region.center, size=design_region.size, material=grid)]


geometry = [mp.Block(center=mp.Vector3(0, Y_BOT + 0.5 * (DPML + DSUB)), size=mp.Vector3(mp.inf, DPML + DSUB), material=SiO2),
            mp.Block(center=design_region.center, size=design_region.size, material=design_variables)]

# ---------------------------------------------------------------- (4) simulation + (5) objective: +1 order amplitude
sim = mp.Simulation(geometry=geometry, eps_averaging=False, **common)
kdiff = mp.Vector3(1 / LAMBDA, np.sqrt(fcen ** 2 - (1 / LAMBDA) ** 2))      # +1 order direction
emc = mpa.EigenmodeCoefficient(sim, mp.Volume(center=mp.Vector3(0, MON_Y), size=mp.Vector3(LAMBDA, 0)), mode=1,
                               eig_parity=mp.ODD_Z, kpoint_func=lambda *_: kdiff,
                               eig_vol=mp.Volume(center=mp.Vector3(0, MON_Y), size=mp.Vector3(1 / RES, 0, 0)))
opt = mpa.OptimizationProblem(simulation=sim, objective_functions=lambda e: npa.abs(e[0]) ** 2, objective_arguments=[emc],
                              design_regions=[design_region], fcen=fcen, df=0, nf=1, decay_by=1e-6)
opt.update_design([x_baseline])
annotated_layout(
    sim, os.path.join(OUT, "01_layout.png"), dpml=DPML, figsize=(5.2, 7.0), axis_step=0.5,
    title="supercell: 1D design region (73 px) replaces the bars",
    params_text=f"wl={wl} res={RES}\nLambda={LAMBDA} H={H}\nNx={Nx} (25 nm px)",
    params_xy=(-0.85, 2.35), pml_xy=(-0.5, Y_BOT + 0.5 * DPML), decay_point=(0, MON_Y), decay_text_xy=(-0.1, 1.75),
    labels=[Label("design region: MaterialGrid, baseline = library bars", (-0.3, Y_DEV + 0.5 * H), (-0.85, 1.25), step=2, color="black"),
            Label("plane wave in SiO2", (0.3, SRC_Y), (-0.85, SRC_Y - 0.35), step=3, color="red"),
            Label("objective: |a_+1|^2 on this line", (0.5, MON_Y), (-0.85, MON_Y + 0.35), step=5, color="blue")])
source_figure(fcen, fwidth, os.path.join(OUT, "00_source.png"), wl_scale=1000.0, wl_unit="nm", time_unit="um/c")


def run_dft_field(src_list, geometry_list):
    s = mp.Simulation(geometry=geometry_list, eps_averaging=False, **dict(common, sources=src_list))
    dft = s.add_dft_fields([mp.Ez], fcen, 0, 1, center=mp.Vector3(), size=mp.Vector3(LAMBDA, SY))
    s.run(until_after_sources=stop_cond)
    field = s.get_dft_array(dft, mp.Ez, 0); eps = s.get_epsilon(); s.reset_meep()
    return field, eps


# ---------------------------------------------------------------- source check + input flux (empty substrate)
sim_ref = mp.Simulation(default_material=SiO2, **common)
fl = sim_ref.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(0, MON_Y), size=mp.Vector3(LAMBDA, 0)))
dft_ref = sim_ref.add_dft_fields([mp.Ez], fcen, 0, 1, center=mp.Vector3(), size=mp.Vector3(LAMBDA, SY))
sim_ref.run(until_after_sources=stop_cond)
input_flux = float(mp.get_fluxes(fl)[0])
field_ref = sim_ref.get_dft_array(dft_ref, mp.Ez, 0)
sim_ref.reset_meep()
row = field_ref[:, field_ref.shape[1] // 2]
phase_spread = float(np.ptp(np.unwrap(np.angle(row))))
print(f"source check: input_flux = {input_flux:.5e}, phase spread across x at mid-height = {phase_spread:.4f} rad ({'normal incidence' if phase_spread < 0.2 else 'TILTED'})")


def fom(x, need_gradient=False):
    """+1 order efficiency = |a_+1|^2 / input_flux (and its gradient w.r.t. the 73 densities)."""
    f, dJ = opt([np.clip(x, 0, 1)], need_gradient=need_gradient)
    f = float(np.real(np.asarray(f).squeeze())) / input_flux
    if not need_gradient:
        return f
    return f, np.squeeze(np.asarray(dJ)) / input_flux


# ---------------------------------------------------------------- forward fields: baseline vs random start; adjoint field
field_fwd, eps_fwd = run_dft_field(sources, geometry_with(x_baseline))
f_baseline, g_baseline = fom(x_baseline, need_gradient=True)
x_random = np.random.rand(Nx)
field_rand, eps_rand = run_dft_field(sources, geometry_with(x_random))
f_random = fom(x_random)
adjoint_sources = opt.adjoint_sources[0]
field_adj, eps_adj = run_dft_field(adjoint_sources, geometry_with(x_baseline))
print(f"forward: baseline +1 efficiency = {f_baseline:.4f} (|grad| = {np.linalg.norm(g_baseline):.3e}); random grayscale start = {f_random:.4f}; "
      f"adjoint sources: {len(adjoint_sources)} x {type(adjoint_sources[0]).__name__}")

xs = np.linspace(EXTENT[0], EXTENT[1], eps_fwd.shape[0]); ys = np.linspace(EXTENT[2], EXTENT[3], eps_fwd.shape[1])
fig, ax = plt.subplots(2, 3, figsize=(10.5, 7.2))
lim = max(np.max(np.abs(field_fwd)), np.max(np.abs(field_rand)))
for col, (fld, eps, ttl) in enumerate(((field_fwd, eps_fwd, f"forward, baseline (library bars)  J = {f_baseline:.3f}"),
                                       (field_rand, eps_rand, f"forward, random grayscale start  J = {f_random:.3f}"),
                                       (field_adj, eps_adj, "adjoint: source placed at the objective monitor"))):
    l = lim if col < 2 else float(np.max(np.abs(fld)))
    ax[0, col].imshow(np.real(fld).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-l, vmax=l, aspect="equal")
    ax[1, col].imshow(np.abs(fld).T, extent=EXTENT, origin="lower", cmap="inferno", aspect="equal")
    for a in ax[:, col]:
        a.contour(xs, ys, eps.T, levels=[1.5, 6.0], colors="w", linewidths=0.6); a.set_xlabel("x [um]")
    ax[0, col].set_title(ttl, fontsize=8.5)
ax[0, 0].set_ylabel("Re(Ez)  y [um]"); ax[1, 0].set_ylabel("|Ez|  y [um]")
fig.suptitle("the field follows the design; the adjoint field flows from the monitor back down", fontsize=10)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "02_fields.png"), dpi=150); plt.close(fig)

# ---------------------------------------------------------------- raw gradient
fig, ax = plt.subplots(2, 1, figsize=(9, 4.8), sharex=True)
ax[0].plot(x_grid, g_baseline, lw=1.2, color="tab:purple"); ax[0].axhline(0, color="k", lw=0.7)
ax[0].fill_between(x_grid, 0, g_baseline, where=g_baseline > 0, color="tab:red", alpha=0.25, label="increase density here")
ax[0].fill_between(x_grid, 0, g_baseline, where=g_baseline < 0, color="tab:blue", alpha=0.25, label="decrease density here")
ax[0].set_ylabel("dJ / d(density)"); ax[0].set_title("raw adjoint gradient at the baseline (no filtering)", fontsize=9); ax[0].legend(fontsize=8, loc="upper right")
ax[1].step(x_grid, x_baseline, where="mid", color="tab:gray", lw=1.3); ax[1].fill_between(x_grid, 0, x_baseline, step="mid", color="tab:gray", alpha=0.35)
ax[1].set_ylabel("density (0 = air, 1 = Si)"); ax[1].set_xlabel("x [um]"); ax[1].set_ylim(-0.05, 1.15); ax[1].set_title("current design", fontsize=9)
for a in ax:
    for j in range(1, N_SEC):
        a.axvline(-0.5 * LAMBDA + j * LA, color="k", ls=":", lw=0.8)
    a.grid(alpha=0.3)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "03_gradient.png"), dpi=150); plt.close(fig)
top = sorted(np.argsort(np.abs(g_baseline))[::-1][:5])
print("gradient: largest 5 |dJ/drho| at x = " + ", ".join(f"{x_grid[i]:+.3f} ({g_baseline[i]:+.3f}, rho={x_baseline[i]:.0f})" for i in top))

# ---------------------------------------------------------------- contract 2: gradient gate (interior point, gradient direction)
x_gate = np.clip(x_baseline, 0.02, 0.98)
f_gate, g_gate = fom(x_gate, need_gradient=True)
v = g_gate / np.linalg.norm(g_gate)
adjoint_dd = float(np.dot(g_gate, v))
steps = [2e-3, 5e-3, 1e-2]
gate_rows = []
for step in steps:
    fd = (fom(x_gate + step * v) - fom(x_gate - step * v)) / (2 * step)
    rel = abs(adjoint_dd - fd) / max(abs(fd), 1e-30)
    gate_rows.append({"step": step, "fd": fd, "adjoint": adjoint_dd, "rel_err": rel, "pass": bool(rel <= 0.20 and np.sign(fd) == np.sign(adjoint_dd))})
gradient_gate = all(r["pass"] for r in gate_rows)
print(f"gate: interior-point FOM = {f_gate:.4f}; " + "; ".join(f"step {r['step']:.0e}: FD {r['fd']:.4e} vs adjoint {r['adjoint']:.4e}, rel {r['rel_err']:.4f} {'PASS' if r['pass'] else 'HOLD'}" for r in gate_rows)
      + f" -> gradient gate {'PASS' if gradient_gate else 'HOLD'}")
fig, ax = plt.subplots(1, 2, figsize=(10, 3.4))
idx = np.arange(len(steps))
ax[0].bar(idx - 0.2, [r["fd"] for r in gate_rows], width=0.4, color="tab:orange", label="centred finite difference")
ax[0].bar(idx + 0.2, [adjoint_dd] * 3, width=0.4, color="tab:blue", label="adjoint  g . v")
ax[0].set_xticks(idx); ax[0].set_xticklabels([f"{s:.0e}" for s in steps]); ax[0].set_xlabel("finite-difference step"); ax[0].set_ylabel("directional derivative")
ax[0].set_title("adjoint vs finite difference along the gradient direction", fontsize=9); ax[0].grid(axis="y", alpha=0.3); ax[0].legend(fontsize=8)
bars = ax[1].bar(idx, [r["rel_err"] for r in gate_rows], color=["tab:green" if r["pass"] else "tab:red" for r in gate_rows])
ax[1].axhline(0.20, ls="--", color="crimson", lw=1.2, label="gate: 20 %")
for b, r in zip(bars, gate_rows):
    ax[1].text(b.get_x() + b.get_width() / 2, r["rel_err"] + 0.004, f"{r['rel_err']:.4f}", ha="center", fontsize=8)
ax[1].set_xticks(idx); ax[1].set_xticklabels([f"{s:.0e}" for s in steps]); ax[1].set_ylim(0, 0.25); ax[1].set_ylabel("relative error")
ax[1].set_title(f"gradient gate: {'PASS' if gradient_gate else 'HOLD'}", fontsize=9); ax[1].grid(axis="y", alpha=0.3); ax[1].legend(fontsize=8)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "04_gate.png"), dpi=150); plt.close(fig)
if not gradient_gate:
    raise SystemExit("gradient gate HOLD: do not interpret optimizer results")

# ---------------------------------------------------------------- one manual step, then MMA (contract 3)
direction = g_baseline / np.linalg.norm(g_baseline)
one_step = []
for alpha in (0.05, 0.3, 0.8, 2.0):
    x_try = np.clip(x_baseline + alpha * direction, 0, 1)
    one_step.append((alpha, x_try, fom(x_try)))
print("one manual step: " + ", ".join(f"alpha {a} -> {f:.4f} ({f - f_baseline:+.4f})" for a, _, f in one_step))

history, design_history = [], []


def nlopt_objective(x, grad):
    f, dJ = fom(x, need_gradient=True)
    if grad.size > 0:
        grad[:] = dJ
    history.append(f); design_history.append(np.array(x, copy=True))
    return f


solver = nlopt.opt(nlopt.LD_MMA, Nx)
solver.set_lower_bounds(np.zeros(Nx)); solver.set_upper_bounds(np.ones(Nx))
solver.set_max_objective(nlopt_objective); solver.set_maxeval(5)
x_optimized = np.clip(solver.optimize(x_baseline.copy()), 0, 1)
best_k = int(np.argmax(history))
x_optimized = design_history[best_k]                         # keep the best evaluated design (MMA may overshoot)
gray = int(np.sum((x_optimized > 0.02) & (x_optimized < 0.98)))
print("MMA (maxeval 5): " + ", ".join(f"eval {k+1}: {f:.4f}" for k, f in enumerate(history)) + f"; best eval {best_k+1} = {max(history):.4f} ({max(history)/history[0]:.3f}x); grayscale pixels {gray}/{Nx}")

fig = plt.figure(figsize=(14, 6.2))
gs = fig.add_gridspec(2, 6, height_ratios=[1, 1])
axs = [fig.add_subplot(gs[0, k]) for k in range(5)]
axs[0].step(x_grid, x_baseline, where="mid", color="tab:gray", lw=1.1); axs[0].fill_between(x_grid, 0, x_baseline, step="mid", color="tab:gray", alpha=0.4)
axs[0].set_title(f"baseline\nJ = {f_baseline:.4f}", fontsize=8); axs[0].set_ylabel("density")
for a, (alpha, x_try, f_try) in zip(axs[1:], one_step):
    a.step(x_grid, x_try, where="mid", color="tab:green", lw=1.1); a.fill_between(x_grid, 0, x_try, step="mid", color="tab:green", alpha=0.4)
    a.set_title(f"one step, alpha = {alpha}\nJ = {f_try:.4f}", fontsize=8)
for a in axs:
    a.set_ylim(-0.05, 1.08); a.set_xlabel("x [um]"); a.grid(alpha=0.3)
axh = fig.add_subplot(gs[0, 5])
axh.plot(range(1, len(history) + 1), history, "o-", color="tab:blue"); axh.axhline(f_baseline, ls="--", color="gray", lw=1, label="baseline")
axh.set_xticks(range(1, len(history) + 1)); axh.set_xlabel("MMA evaluation"); axh.set_ylabel("+1 efficiency"); axh.set_title("MMA history", fontsize=8); axh.grid(alpha=0.3); axh.legend(fontsize=7)
for k in range(len(design_history)):
    a = fig.add_subplot(gs[1, k])
    a.step(x_grid, design_history[k], where="mid", color="tab:blue", lw=1.0); a.fill_between(x_grid, 0, design_history[k], step="mid", color="tab:blue", alpha=0.4)
    a.set_title(f"MMA eval {k + 1}  J = {history[k]:.4f}" + ("  (kept)" if k == best_k else ""), fontsize=8); a.set_ylim(-0.05, 1.08); a.set_xlabel("x [um]"); a.grid(alpha=0.3)
    if k == 0:
        a.set_ylabel("density")
a = fig.add_subplot(gs[1, 5])
a.step(x_grid, x_baseline, where="mid", color="tab:gray", lw=1.2, label="baseline"); a.step(x_grid, x_optimized, where="mid", color="tab:blue", lw=1.2, label="optimized")
a.fill_between(x_grid, 0, x_optimized, step="mid", color="tab:blue", alpha=0.3); a.set_ylim(-0.05, 1.08); a.set_xlabel("x [um]"); a.set_title(f"final vs baseline ({gray} gray px)", fontsize=8); a.legend(fontsize=7); a.grid(alpha=0.3)
fig.suptitle("top: one manual gradient step (alpha sweep) and the MMA history; bottom: the design at every MMA evaluation", fontsize=10)
fig.tight_layout(); fig.savefig(os.path.join(OUT, "05_step_mma.png"), dpi=150); plt.close(fig)


# ---------------------------------------------------------------- contract 4: verification in a fresh simulation
def forward_orders(weights):
    s = mp.Simulation(geometry=geometry_with(weights), eps_averaging=False, **common)
    mon = s.add_mode_monitor(fcen, 0, 1, mp.ModeRegion(center=mp.Vector3(0, MON_Y), size=mp.Vector3(LAMBDA, 0)))
    dft = s.add_dft_fields([mp.Ez], fcen, 0, 1, center=mp.Vector3(), size=mp.Vector3(LAMBDA, SY))
    s.run(until_after_sources=stop_cond)
    total = float(mp.get_fluxes(mon)[0] / input_flux)
    eff = {m: float(abs(s.get_eigenmode_coefficients(mon, mp.DiffractedPlanewave((m, 0, 0), mp.Vector3(1, 0, 0), 1, 0)).alpha[0, 0, 0]) ** 2 / input_flux) for m in (-1, 0, 1)}
    field = s.get_dft_array(dft, mp.Ez, 0); eps = s.get_epsilon(); s.reset_meep()
    return eff, total, field, eps


report = {}
for tag, weights in (("baseline", x_baseline), ("optimized", x_optimized)):
    eff, total, fld, eps = forward_orders(weights)
    report[tag] = {"orders": eff, "sum": sum(eff.values()), "T_total": total, "field": fld, "eps": eps}
    print(f"verify [{tag}]: m=-1 {eff[-1]:.4f}, m=0 {eff[0]:.4f}, m=+1 {eff[1]:.4f}; sum {sum(eff.values()):.4f} = total {total:.4f}; "
          f"+1 / bound = {eff[1] / BLAZED_BOUND * 100:.1f} %")
fig, ax = plt.subplots(1, 3, figsize=(13, 4.4), gridspec_kw={"width_ratios": [1.4, 1, 1]})
ms = (-1, 0, 1); idx = np.arange(3)
ax[0].bar(idx - 0.2, [report["baseline"]["orders"][m] for m in ms], width=0.4, color="tab:gray", label="baseline (post-07 library)")
ax[0].bar(idx + 0.2, [report["optimized"]["orders"][m] for m in ms], width=0.4, color="tab:blue", label=f"after MMA (eval {best_k + 1})")
ax[0].axhline(BLAZED_BOUND, ls="--", color="crimson", lw=1.2, label=f"4-level blazed bound {BLAZED_BOUND:.3f}")
for k, m in enumerate(ms):
    ax[0].text(k - 0.2, report["baseline"]["orders"][m] + 0.008, f"{report['baseline']['orders'][m]:.3f}", ha="center", fontsize=8)
    ax[0].text(k + 0.2, report["optimized"]["orders"][m] + 0.008, f"{report['optimized']['orders'][m]:.3f}", ha="center", fontsize=8)
ax[0].set_xticks(idx); ax[0].set_xticklabels([f"m = {m:+d}" for m in ms]); ax[0].set_ylim(0, 1.0); ax[0].set_ylabel("efficiency (fresh forward run)")
ax[0].set_title("contract 4: measured again in a new simulation", fontsize=9); ax[0].grid(axis="y", alpha=0.3); ax[0].legend(fontsize=7)
lim = max(np.max(np.abs(report["baseline"]["field"])), np.max(np.abs(report["optimized"]["field"])))
for a, tag in zip(ax[1:], ("baseline", "optimized")):
    fld, eps = report[tag]["field"], report[tag]["eps"]
    a.imshow(np.real(fld).T, extent=EXTENT, origin="lower", cmap="RdBu", vmin=-lim, vmax=lim, aspect="equal")
    a.contour(xs, ys, eps.T, levels=[1.5, 6.0], colors="w", linewidths=0.6); a.set_title(f"Re(Ez), {tag}", fontsize=9); a.set_xlabel("x [um]")
ax[1].set_ylabel("y [um]")
fig.tight_layout(); fig.savefig(os.path.join(OUT, "06_verify.png"), dpi=150); plt.close(fig)

# ---------------------------------------------------------------- GIF: optimized pattern repeated 5 times, short pulse
periods = 5
fw_anim = 0.4 * fcen
aperture = periods * LAMBDA
sx_a = aperture + 2 * 1.0 + 2 * DPML
sy_a = DPML + DSUB + H + 2.5 + DPML
yb = -0.5 * sy_a
ydev = yb + DPML + DSUB
geom_a = [mp.Block(center=mp.Vector3(0, yb + 0.5 * (DPML + DSUB)), size=mp.Vector3(mp.inf, DPML + DSUB), material=SiO2)]
for j in range(periods):
    xj = -0.5 * aperture + (j + 0.5) * LAMBDA
    geom_a.append(mp.Block(center=mp.Vector3(xj, ydev + 0.5 * H), size=mp.Vector3(LAMBDA, H),
                           material=mp.MaterialGrid(mp.Vector3(Nx, Ny), mp.air, Si, weights=x_optimized.reshape(Nx, Ny), grid_type="U_MEAN", do_averaging=False)))
sim_a = mp.Simulation(resolution=RES, cell_size=mp.Vector3(sx_a, sy_a), boundary_layers=[mp.PML(DPML)], geometry=geom_a, eps_averaging=False,
                      sources=[mp.Source(mp.GaussianSource(fcen, fwidth=fw_anim, is_integrated=True), component=mp.Ez,
                                         center=mp.Vector3(0, yb + DPML + 0.3), size=mp.Vector3(aperture, 0))])
sim_a.init_sim()
vol_a = mp.Volume(center=mp.Vector3(), size=mp.Vector3(sx_a - 2 * DPML, sy_a - 2 * DPML))
eps_a = sim_a.get_array(vol=vol_a, component=mp.Dielectric)
ext_a = [-(sx_a / 2 - DPML), sx_a / 2 - DPML, -(sy_a / 2 - DPML), sy_a / 2 - DPML]
t_src = 5 / fw_anim
frames, times = record_frames(sim_a, vol_a, mp.Ez, t_start=t_src - 1 / fw_anim, t_end=t_src + 1.2 * sy_a * 1.45, n_frames=60)
animate_fields(frames, times, ext_a, os.path.join(OUT, "07_anim_optimized.gif"), eps=eps_a, figsize=(6.4, 4.6), dpi=70,
               title=f"optimized metagrating x{periods}: wavefront toward +{THETA_D:.0f} deg", legend_loc="lower right")

if mp.am_master():
    with open(os.path.join(OUT, "result.json"), "w") as f:
        json.dump({"params": {"wl": wl, "Lambda": LAMBDA, "H": H, "theta_d": THETA_D, "Nx": Nx, "w_lib": W_LIB.tolist()},
                   "input_flux": input_flux, "phase_spread": phase_spread,
                   "fom": {"baseline": f_baseline, "random": f_random, "gate_point": f_gate},
                   "gate": gate_rows, "gate_pass": gradient_gate,
                   "one_step": [{"alpha": a, "fom": f} for a, _, f in one_step],
                   "mma": {"history": history, "best_eval": best_k + 1, "gray_pixels": gray},
                   "verify": {k: {"orders": v["orders"], "sum": v["sum"], "T_total": v["T_total"]} for k, v in report.items()},
                   "blazed_bound": BLAZED_BOUND, "x_baseline": x_baseline.tolist(), "x_optimized": x_optimized.tolist(),
                   "wall_s_total": time.time() - t_all, "meep": mp.__version__, "nlopt": f"{nlopt.version_major()}.{nlopt.version_minor()}"}, f, indent=2)
원본 실행 기록과 재현 환경
§4의 발췌 코드와 달리 전체 코드에는 그림 저장·GIF 녹화·result.json 기록이 들어 있다. 그림 helper blogfig.py는 시리즈 공통이며 같은 폴더(code/)에 있다. 전체 코드와 helper: https://github.com/jin-castle/meep-examples/blob/main/code.
실행 결과 (2026-10-23 실행):
source check: input_flux = 1.86866e+01, phase spread across x at mid-height = 0.0000 rad (normal incidence)
forward: baseline +1 efficiency = 0.4970 (|grad| = 6.037e-01); random grayscale start = 0.0177; adjoint sources: 1 x EigenModeSource
gradient: largest 5 |dJ/drho| at x = -0.275 (+0.157, rho=0), -0.250 (+0.208, rho=1), -0.225 (+0.232, rho=1), -0.200 (+0.215, rho=1), -0.175 (+0.165, rho=0)
gate: interior-point FOM = 0.4871; step 2e-03: FD 5.4104e-01 vs adjoint 5.4472e-01, rel 0.0068 PASS; step 5e-03: FD 5.4538e-01 vs adjoint 5.4472e-01, rel 0.0012 PASS; step 1e-02: FD 5.4505e-01 vs adjoint 5.4472e-01, rel 0.0006 PASS -> gradient gate PASS
one manual step: alpha 0.05 -> 0.5075 (+0.0105), alpha 0.3 -> 0.5549 (+0.0579), alpha 0.8 -> 0.6134 (+0.1163), alpha 2.0 -> 0.4840 (-0.0130)
MMA (maxeval 5): eval 1: 0.4970, eval 2: 0.5248, eval 3: 0.6241, eval 4: 0.0492, eval 5: 0.5398; best eval 3 = 0.6241 (1.256x); grayscale pixels 27/73
verify [baseline]: m=-1 0.1026, m=0 0.0666, m=+1 0.4959; sum 0.6651 = total 0.6651; +1 / bound = 61.2 %
verify [optimized]: m=-1 0.0973, m=0 0.0169, m=+1 0.6228; sum 0.7369 = total 0.7369; +1 / bound = 76.8 %
재현 환경: meep 1.33.0 · nlopt 2.x · autograd · Python 3.11 · conda install -c conda-forge pymeep nlopt autograd · 실행 python metagrating_inverse.py (약 48 s, 단일 코어)